Concepts et Architecture LLMaaS
Vue d'Ensemble
Le service LLMaaS (Large Language Models as a Service) de Cloud Temple fournit un accès sécurisé et souverain aux modèles d'intelligence artificielle les plus avancés, avec la qualification SecNumCloud de l'ANSSI.
🏗️ Architecture Technique
Infrastructure Cloud Temple
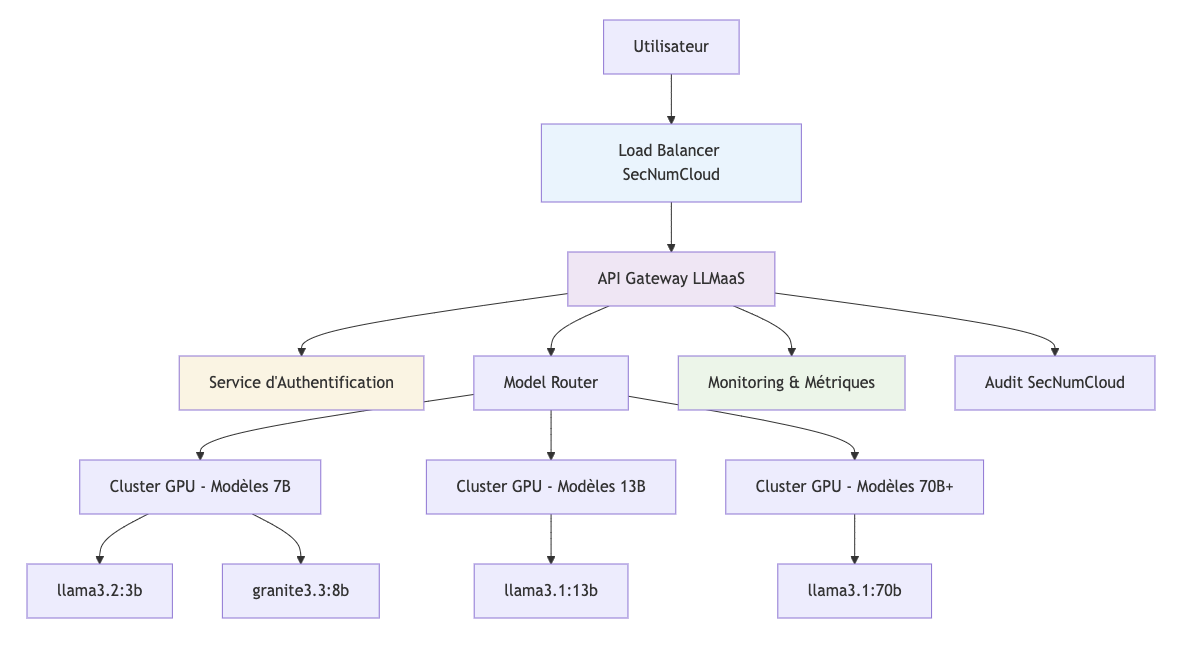
Composants Principaux
1. API Gateway LLMaaS
- Compatible OpenAI : Intégration transparente avec écosystème existant
- Rate Limiting : Gestion des quotas par tier de facturation
- Load Balancing : Distribution des requêtes sur les ressources d'inférence
- Monitoring : Métriques temps réel et alerting
2. Service d'Authentification
- Clés API : Création, rotation et révocation sous la responsabilité du client. Voir le partage des responsabilités (RACI).
- Contrôle d'accès : Permissions granulaires par modèle
- Audit trails : Traçabilité complète des accès
🤖 Modèles et Tokens
Catalogue de Modèles
Consultez le catalogue et cycle de vie et le guide de choix.
Gestion des Tokens
Types de Tokens
- Tokens d'entrée : Votre prompt et contexte
- Tokens de sortie : Réponse générée par le modèle
- Tokens système : Metadata et instructions
Calcul des Coûts
Pour connaître les prix publics en vigueur et établir votre estimation, consultez le catalogue tarifaire officiel Cloud Temple.
Le coût dépend des volumes consommés (tokens, documents ou durée audio) et des unités de facturation applicables.
Optimisation
- Context window : Réutilisez les conversations pour économiser
- Modèles appropriés : Choisissez la taille selon la complexité
- Max tokens : Limitez la longueur des réponses
Tokenisation
# Exemple d'estimation de tokens
def estimate_tokens(text: str) -> int:
    """Estimation approximative : 1 token ≈ 4 caractères"""
    return len(text) // 4

prompt = "Expliquez la photosynthèse"
response_max = 200  # tokens max souhaités

estimated_input = estimate_tokens(prompt)  # ~6 tokens
print(f"Tokens estimés : {estimated_input}; limite de sortie : {response_max}")
🔒 Sécurité et Conformité
Qualification SecNumCloud
Le service LLMaaS est calculé sur une infrastructure technique qui bénéficie de la qualification SecNumCloud 3.2 de l'ANSSI, garantissant :
Protection des Données
- Chiffrement bout en bout : TLS 1.3 pour tous les échanges
- Stockage sécurisé : Données chiffrées au repos (AES-256)
Souveraineté Numérique
- Hébergement France : Datacenters Cloud Temple certifiés
- Droit français : Conformité RGPD native
- Pas d'exposition : Aucun transfert vers clouds étrangers
Audit et Traçabilité
- Logs complets : Toutes les interactions tracées
- Rétention : Conservation selon politiques légales
- Compliance : Rapports d'audit disponibles
Contrôles de Sécurité

Sécurité des Prompts
La plateforme LLMaaS n'applique pas de filtrage automatique du contenu des prompts contre les injections ou les tentatives de contournement des instructions (jailbreaks).
Les contrôles de contenu sont à mettre en œuvre dans votre application selon votre cas d'usage. Vous pouvez appeler explicitement un modèle de sécurité du catalogue pour évaluer les entrées ou les réponses. Ces modèles ne sont pas exécutés automatiquement sur les requêtes adressées aux autres modèles.
Définissez les critères de filtrage et le traitement des résultats avec vos équipes métier, puis testez-les sur vos données, notamment pour mesurer les faux positifs. Le partage des responsabilités précise les rôles du client et de Cloud Temple.
📈 Performance et Scalabilité
Monitoring en Temps Réel
Access via Console Cloud Temple :
- Métriques d'utilisation par modèle
- Graphiques de latence et débit
- Alertes sur seuils de performance
- Historique des requêtes
🌐 Intégration et Écosystème
Compatibilité OpenAI
Le service LLMaaS est compatible avec l'API OpenAI :
# Migration transparente
from openai import OpenAI

# Avant (OpenAI)
client_openai = OpenAI(api_key="sk-...")

# Après (Cloud Temple LLMaaS)
client_ct = OpenAI(
    api_key="votre-token-cloud-temple",
    base_url="https://api.ai.cloud-temple.com/v1"
)

# Code identique !
response = client_ct.chat.completions.create(
    model="gpt-oss:120b",  # Modèle Cloud Temple
    messages=[{"role": "user", "content": "Bonjour"}]
)
Écosystème Supporté
Frameworks IA
- ✅ LangChain : Intégration native
- ✅ Haystack : Pipeline de documents
- ✅ Semantic Kernel : Orchestration Microsoft
- ✅ AutoGen : Agents conversationnels
Outils Développement
- ✅ Jupyter : Notebooks interactifs
- ✅ Streamlit : Applications web rapides
- ✅ Gradio : Interfaces utilisateur IA
- ✅ FastAPI : APIs backend
Plateformes No-Code
- ✅ Zapier : Automatisations
- ✅ Make : Intégrations visuelles
- ✅ Bubble : Applications web
🔄 Cycle de Vie des Modèles
Le cycle de vie des modèles publie les statuts, échéances et migrations conseillées. Consultez-le avant de choisir un modèle et pendant l'exploitation de votre application.
Lire le cycle de vie
- DMP : date de mise en production.
- DSP : date de sortie de production (fin de support) annoncée pour le modèle.
- LTS (Long Term Support) : modèle bénéficiant d'un support étendu ; vérifiez la date publiée pour le modèle concerné.
- Production : modèle indiqué en production dans le catalogue.
- Deprecated : modèle déprécié pour lequel une migration doit être préparée. Ce statut ne signifie pas nécessairement que les appels API sont déjà interrompus.
- Planned : modèle annoncé, dont la disponibilité doit être vérifiée avant utilisation.
Les annonces d'ajout, de redirection et de retrait sont publiées dans le changelog du service. Pour un besoin de stabilité ou de support particulier, contactez le support afin de préciser les modalités applicables.
Redirections et anciens identifiants
Certains anciens identifiants sont redirigés vers un modèle successeur. Une requête peut donc continuer à fonctionner tout en étant traitée par un autre modèle. La continuité de l'appel API ne garantit pas des réponses identiques, ni les mêmes capacités, latences ou limites de contexte.
Migration vers un autre modèle
- Repérez le modèle concerné, l'échéance et le successeur conseillé dans le cycle de vie.
- Vérifiez l'identifiant du successeur avec
GET /v1/modelset ses capacités : vision, appels d'outils, raisonnement et contexte selon votre usage. - Testez le successeur sur un échantillon représentatif de vos requêtes : qualité, formats de sortie, outils, latence et consommation.
- Mettez à jour le paramètre
modeldans la configuration de votre application après validation, puis surveillez les résultats. - Pour les embeddings, prévoyez de recalculer les vecteurs et de reconstruire l'index si le modèle change.
Modèles dépréciés
La liste et les destinations de migration sont disponibles dans le catalogue de cycle de vie. Si aucune migration n'est indiquée, contactez le support avant l'échéance pour choisir une solution adaptée.
💡 Bonnes Pratiques
Pour tirer le meilleur parti de l'API LLMaaS, il est essentiel d'adopter des stratégies d'optimisation des coûts, de la performance et de la sécurité.
Optimisation des Coûts
La maîtrise des coûts repose sur une utilisation intelligente des tokens et des modèles.
-
Choix du Modèle : Comparez plusieurs modèles sur des exemples représentatifs de votre usage. Retenez celui qui répond à vos exigences de qualité et de latence, puis mesurez sa consommation de tokens. Consultez le catalogue de cycle de vie pour identifier les modèles disponibles et leurs successeurs. La facturation dépend du tarif applicable et des volumes consommés ; la taille du modèle seule ne détermine pas le coût facturé.
-
Gestion du Contexte : L'historique de la conversation (
messages) est renvoyé à chaque appel, consommant des tokens d'entrée. Pour des conversations longues, envisagez des stratégies de résumé ou de fenêtrage pour ne conserver que les informations pertinentes.# Pour une conversation longue, on peut résumer les premiers échanges.messages = [{"role": "system", "content": "Vous êtes un assistant IA."},{"role": "user", "content": "Résumé des 10 premiers échanges..."},{"role": "assistant", "content": "Ok, j'ai le contexte."},{"role": "user", "content": "Voici ma nouvelle question."}] -
Limitation des Tokens de Sortie : Utilisez toujours le paramètre
max_tokenspour éviter des réponses excessivement longues et coûteuses. Fixez une limite raisonnable en fonction de ce que vous attendez.# Demander un résumé de 100 mots maximum.response = client.chat.completions.create(model="gpt-oss:120b",messages=[{"role": "user", "content": "Résume ce document..."}],max_tokens=150, # Marge de sécurité for ~100 mots)
Performance
La réactivité de votre application dépend de la manière dont vous gérez les appels à l'API.
-
Requêtes Asynchrones : Pour traiter plusieurs requêtes sans attendre la fin de chacune, utilisez des appels asynchrones. C'est particulièrement utile pour les applications backend traitant un grand volume de requêtes simultanées.
import asynciofrom openai import AsyncOpenAIclient = AsyncOpenAI(api_key="...", base_url="...")async def process_prompt(prompt: str):# Traite une seule requête de manière asynchroneresponse = await client.chat.completions.create(model="gpt-oss:120b", messages=[{"role": "user", "content": prompt}])return response.choices[0].message.contentasync def batch_requests(prompts: list):# Lance plusieurs tâches en parallèle et attend leur complétiontasks = [process_prompt(p) for p in prompts]return await asyncio.gather(*tasks) -
Streaming pour l'Expérience Utilisateur (UX) : Pour les interfaces utilisateur (chatbots, assistants), le streaming est essentiel. Il permet d'afficher la réponse du modèle mot par mot, donnant une impression de réactivité immédiate au lieu d'attendre la réponse complète.
# Affiche la réponse en temps réel dans une interface utilisateurresponse_stream = client.chat.completions.create(model="gpt-oss:120b",messages=[{"role": "user", "content": "Raconte-moi une histoire."}],stream=True)for chunk in response_stream:if chunk.choices[0].delta.content:# Afficher le morceau de texte dans l'UIprint(chunk.choices[0].delta.content, end="", flush=True)
Sécurité
La sécurité de votre application est primordiale, surtout lorsque vous traitez des entrées utilisateur.
-
Validation et Nettoyage des Entrées (Sanitization) : Ne faites jamais confiance aux entrées utilisateur. Avant de les envoyer à l'API, nettoyez-les pour retirer tout code potentiellement malveillant ou instructions de "prompt injection". Limitez également leur taille pour éviter les abus.
def sanitize_input(user_input: str) -> str:# Exemple simple : retirer les démarqueurs de code et limiter la longueur.# Des bibliothèques plus robustes peuvent être utilisées pour une sanitization avancée.cleaned = user_input.replace("`", "").replace("'", "").replace("\"", "")return cleaned[:2000] # Limite la taille à 2000 caractères -
Gestion Robuste des Erreurs : Encadrez toujours vos appels API dans des blocs
try...exceptpour gérer les erreurs réseau, les erreurs de l'API (ex: 429 Rate Limit, 500 Internal Server Error) et fournir une expérience utilisateur dégradée mais fonctionnelle.from openai import APIError, APITimeoutErrortry:response = client.chat.completions.create(...)except APITimeoutError:# Gérer le cas où la requête prend trop de tempsreturn "Le service prend plus de temps que prévu, veuillez réessayer."except APIError as e:# Gérer les erreurs spécifiques à l'APIlogger.error(f"Erreur API LLMaaS: {e.status_code} - {e.message}")return "Désolé, une erreur est survenue avec le service d'IA."except Exception as e:# Gérer toutes les autres erreurs (réseau, etc.)logger.error(f"Une erreur inattendue est survenue: {e}")return "Désolé, une erreur inattendue est survenue."