Tutoriali LLMaaS
Le credenziali utilizzate illustrano le integrazioni. Verificarne la disponibilità con GET /v1/models, le loro capacità e il loro ciclo di vita. Adattare la configurazione al proprio utilizzo; un nome obsoleto potrebbe essere reindirizzato a un successore.
Panoramica
Questi tutorial presentano esempi di integrazione con LLMaaS. L'ambito delle verifiche degli esempi LangChain è specificato di seguito; i risultati e i dati di dimostrazione non costituiscono misure di prestazione del servizio.
🚀 Integrazioni LangChain e Framework
Prerequisiti LangChain
Gli esempi LangChain da 1 a 4 e quelli del riferimento API sono stati verificati il 7 settembre 2026 con Python 3.13.15 e le versioni seguenti. Installarli in un ambiente dedicato:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install \
  langchain-classic==1.0.8 langchain-core==1.6.2 langchain-openai==1.6.0 \
  langchain-community==0.4.2 langchain-text-splitters==1.1.2 \
  langchain-qdrant==1.1.0 qdrant-client==1.19.0 faiss-cpu==1.15.0 \
  pydantic==2.13.5 python-dotenv==1.2.3 requests==2.34.2 httpx==0.28.1
Queste versioni fissano un ambiente di riferimento; rivalutare gli esempi prima di aggiornare le dipendenze.
Le catene storiche LLMChain, RetrievalQA e l'agente ReAct di questi tutorial utilizzano langchain-classic, conformemente alla guida di migrazione LangChain. Questa scelta mantiene la struttura degli esempi esistenti; alcune classi emettono avvisi di deprecazione. Per un nuovo progetto, consultare le interfacce attuali raccomandate da LangChain.
Verifiche effettuate: caricamento degli esempi, invocazione del wrapper, ricerca e generazione con FAISS e Qdrant in memoria, esecuzione di uno strumento da parte dell'agente, chat ed embeddings del riferimento API. Le risposte HTTP LLMaaS erano simulate e gli accessi di rete bloccati. Queste verifiche non validano né i modelli in produzione né la connessione a un server Qdrant remoto.
1. Integrazione di base con LangChain
Questo primo esempio mostra come integrare la nostra API LLMaaS con il framework popolare LangChain creando un "wrapper" personalizzato. Un wrapper è una classe che "avvolge" la nostra API per renderla compatibile con i meccanismi interni di LangChain.
Il codice spiegato
Il codice di seguito definisce una classe CloudTempleLLM che eredita dalla classe base LLM di LangChain. Questo ci permette di definire un comportamento su misura restando compatibili con l'ecosistema LangChain (catene, agenti, ecc.).
CloudTempleLLM(LLM): La nostra classe eredita daLLM, il che ci obbliga a implementare alcuni metodi, tra cui_call._call(self, prompt: str, ...): Questo è il cuore del nostro wrapper. Ogni volta che LangChain avrà bisogno di chiamare il nostro modello linguistico, invocherà questo metodo. All'interno, formattiamo una richiesta HTTP POST standard con le intestazioni corrette (Authorization) e ilpayloadatteso dalla nostra API/v1/chat/completions.exemple_langchain_wrapper(): Questa funzione di dimostrazione mostra come utilizzare il nostro wrapper. La istanziamo, creiamo unPromptTemplateper strutturare la nostra richiesta e li combiniamo in unaLLMChain. Quando eseguiamo la catena (chain.invoke(...)), LangChain chiama in background il metodo_callche abbiamo definito.
Questo approccio è utile se si desidera un controllo totale su come LangChain interagisce con l'API, ma è più verboso rispetto all'utilizzo del client ChatOpenAI (vedere Riferimento API).
# Installation des dépendances
# Voir les versions validées dans les prérequis LangChain ci-dessus.

from langchain_core.language_models.llms import LLM
from typing import Optional, List, Any
from pydantic import Field
import requests
import json
import os

# --- Configuration ---
# Il est recommandé de stocker votre clé API dans une variable d'environnement
API_KEY = os.getenv("LLMAAS_API_KEY", "votre-clé-api-ici")
BASE_URL = "https://api.ai.cloud-temple.com/v1"

class CloudTempleLLM(LLM):
    """
    Wrapper LangChain personnalisé pour l'API LLMaaS de Cloud Temple.
    Cette classe permet d'utiliser notre API comme un LLM standard dans LangChain.
    """

    api_key: str = Field(default="")
    model_name: str = Field(default="gpt-oss:120b")
    temperature: float = Field(default=0.7)
    max_tokens: int = Field(default=1000)

    @property
    def _llm_type(self) -> str:
        """Identifiant unique pour notre type de LLM."""
        return "cloud_temple_llmaas"

    def _call(self, prompt: str, stop: Optional[List[str]] = None) -> str:
        """
        La méthode principale qui effectue l'appel à l'API LLMaaS.
        LangChain utilise cette méthode pour chaque requête au modèle.
        """
        headers = {
            "Authorization": f"Bearer {self.api_key}",
            "Content-Type": "application/json"
        }

        payload = {
            "model": self.model_name,
            "messages": [{"role": "user", "content": prompt}],
            "temperature": self.temperature,
            "max_tokens": self.max_tokens
        }

        if stop:
            payload["stop"] = stop

        # Exécution de la requête POST vers l'API
        response = requests.post(
            f"{BASE_URL}/chat/completions",
            headers=headers,
            json=payload,
            timeout=60
        )

        response.raise_for_status()  # Lève une exception en cas d'erreur HTTP
        result = response.json()

        # Retourne le contenu du message de l'assistant
        return result['choices'][0]['message']['content']

# --- Exemple d'utilisation ---
from langchain_classic.chains import LLMChain
from langchain_core.prompts import PromptTemplate

def exemple_langchain_wrapper():
    """Démontre l'utilisation du wrapper LLM avec une chaîne LangChain."""

    # 1. Initialisation de notre LLM personnalisé
    llm = CloudTempleLLM(
        api_key=API_KEY,
        model_name="gpt-oss:120b"
    )

    # 2. Création d'un template de prompt pour structurer les requêtes
    template = """
    Tu es un expert en {domaine}.
    Réponds à cette question de manière détaillée et professionnelle :

    Question: {question}

    Réponse:
    """
    prompt = PromptTemplate(
        input_variables=["domaine", "question"],
        template=template
    )

    # 3. Création d'une chaîne qui combine le prompt et le LLM
    chain = LLMChain(llm=llm, prompt=prompt)

    # 4. Exécution de la chaîne avec des variables spécifiques
    result = chain.invoke({
        "domaine": "cybersécurité",
        "question": "Quelles sont les meilleures pratiques pour sécuriser une API REST ?"
    })

    return result["text"]

# --- Lancement du test ---
if __name__ == "__main__":
    if API_KEY == "votre-clé-api-ici":
        print("Veuillez configurer votre LLMAAS_API_KEY dans vos variables d'environnement.")
    else:
        reponse = exemple_langchain_wrapper()
        print("Réponse de l'expert en cybersécurité :\n")
        print(reponse)
2. RAG (Retrieval-Augmented Generation) con l'API LLMaaS
Il RAG è una tecnica potente che permette a un LLM di rispondere a domande basandosi su una base di conoscenze esterna. Questo tutorial ti guida attraverso la creazione di una pipeline RAG semplice utilizzando la nostra API per gli embeddings e la generazione, e FAISS, una libreria di similarità vettoriale, per creare un indice in memoria.
Il codice spiegato
Il pipeline si scompone in diverse fasi logiche:
- Configurazione: Importiamo le librerie necessarie e carichiamo la nostra chiave API dalle variabili di ambiente. Definiamo i modelli da utilizzare:
granite-embedding:278mper la vettorizzazione egpt-oss:120bper la generazione. OpenAIEmbeddings: Il client standard invia i testi a LLMaaS concheck_embedding_ctx_length=Falsee richiede vettori numerici conencoding_format="float". La suddivisione dei documenti avviene prima della chiamata; consulta le impostazioni embeddings.setup_rag_pipeline: Questa funzione coordina la creazione del pipeline.- Caricamento dei documenti:
DirectoryLoadercarica i file di testo dalla nostra base di conoscenza. - Divisione in chunk:
RecursiveCharacterTextSplitterdivide i documenti in pezzi più piccoli. Questo è essenziale affinché il modello di embedding possa elaborare il testo in modo efficiente e affinché la ricerca per similarità sia precisa. - Vettorizzazione e Indicizzazione:
FAISS.from_documentsè un passaggio chiave. Prende i chunk di testo, utilizza il clientOpenAIEmbeddingsper chiamare l'API e ottenere i vettori corrispondenti, quindi memorizza questi vettori in un indice FAISS in memoria. - Configurazione del LLM: Utilizziamo
ChatOpenAIche è nativamente compatibile con la nostra API per la parte di generazione delle risposte. - Creazione della catena
RetrievalQA: È la catena LangChain che collega tutti gli elementi. Quando le viene posta una domanda, essa: a. Utilizza ilretriever(basato sul nostro indice FAISS) per trovare i chunk di testo più pertinenti. b. "Inserisce" (stuff) questi chunk in un prompt insieme alla domanda. c. Invia questo prompt arricchito al LLM per generare una risposta contestuale.
- Caricamento dei documenti:
- Esecuzione: La funzione
mainsimula un utilizzo reale creando file di conoscenza temporanei, costruendo il pipeline e ponendo una domanda.
import os
import tempfile
import shutil
from pathlib import Path
from dotenv import load_dotenv

# --- Imports LangChain ---
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import FAISS
from langchain_classic.chains import RetrievalQA

# --- Configuration ---
# Charge les variables d'environnement (ex: LLMAAS_API_KEY)
load_dotenv()
API_KEY = os.getenv("LLMAAS_API_KEY")
BASE_URL = os.getenv("API_URL", "https://api.ai.cloud-temple.com/v1")
EMBEDDING_MODEL = "granite-embedding:278m"
LLM_MODEL = "gpt-oss:120b"

# --- Pipeline RAG ---
def setup_rag_pipeline(documents_path: str):
    """Configuration complète du pipeline RAG avec les outils LLMaaS."""
    print("1. Chargement et division des documents...")
    loader = DirectoryLoader(documents_path, glob="*.txt", loader_cls=TextLoader, loader_kwargs={'encoding': 'utf-8'})
    documents = loader.load()
    text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
    splits = text_splitter.split_documents(documents)
    print(f"   -> {len(documents)} document(s) chargé(s) et divisé(s) en {len(splits)} chunks.")

    print(f"2. Création des embeddings via LLMaaS (modèle: {EMBEDDING_MODEL})...")
    embeddings = OpenAIEmbeddings(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=EMBEDDING_MODEL,
        check_embedding_ctx_length=False,
        model_kwargs={"encoding_format": "float"},
    )

    print("3. Création de l'index vectoriel en mémoire (FAISS)...")
    vectorstore = FAISS.from_documents(splits, embeddings)
    print("   -> Index FAISS créé avec succès.")

    print(f"4. Configuration du LLM (modèle: {LLM_MODEL})...")
    llm = ChatOpenAI(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=LLM_MODEL,
        temperature=0.3,
        max_tokens=300
    )

    print("5. Création de la chaîne de Question/Réponse (RAG)...")
    qa_chain = RetrievalQA.from_chain_type(
        llm=llm,
        chain_type="stuff",
        retriever=vectorstore.as_retriever(),
        return_source_documents=True
    )
    print("   -> Pipeline RAG prêt.")
    return qa_chain

# --- Exécution ---
def main():
    """Fonction principale pour exécuter le pipeline RAG de bout en bout."""
    if not API_KEY:
        print("Erreur: La variable d'environnement LLMAAS_API_KEY n'est pas définie.")
        return

    # Créer des documents de test temporaires
    temp_dir = tempfile.mkdtemp()
    print(f"\nCréation de documents de test dans: {temp_dir}")
    try:
        documents_content = {
            "overview.txt": "Cloud Temple est un fournisseur de cloud souverain français qualifié SecNumCloud.",
            "pricing.txt": "Consultez le catalogue tarifaire officiel : https://www.cloud-temple.com/nos-tarifs-publics/"
        }
        for filename, content in documents_content.items():
            with open(Path(temp_dir) / filename, 'w', encoding='utf-8') as f:
                f.write(content)

        # Configurer et exécuter le pipeline
        rag_chain = setup_rag_pipeline(temp_dir)

        print("\n--- Interrogation du Pipeline RAG ---")
        question = "Quel est le tarif des tokens en sortie sur l'API LLMaaS de Cloud Temple ?"
        result = rag_chain.invoke({"query": question})

        print(f"\nQuestion: {question}")
        print(f"Réponse: {result['result']}")
        print("\nSources utilisées pour la réponse:")
        for source in result["source_documents"]:
            print(f"- Fichier: {os.path.basename(source.metadata['source'])}")
            print(f"  Contenu: \"{source.page_content}\"")

    finally:
        # Nettoyer le répertoire temporaire
        print(f"\nNettoyage du répertoire temporaire: {temp_dir}")
        shutil.rmtree(temp_dir)

if __name__ == "__main__":
    main()
3. Integrazione con un database vettoriale (Qdrant)
Per applicazioni RAG in produzione, si consiglia l'utilizzo di un database vettoriale dedicato come Qdrant. A differenza di FAISS che funziona in memoria, Qdrant offre persistenza dei dati, capacità di ricerca avanzate e una migliore scalabilità.
Il codice spiegato
Questo tutorial adatta il pipeline RAG precedente per utilizzare Qdrant.
- Prerequisiti: Il primo passo è avviare un'istanza di Qdrant. Il modo più semplice è utilizzare Docker.
setup_qdrant_rag_pipeline:- Embeddings e Documenti: La creazione degli embeddings e dei documenti rimane identica all'esempio precedente.
- Connessione a Qdrant: Invece di creare un indice FAISS, utilizziamo
QdrantVectorStore.from_documents. Questo metodo LangChain gestisce diversi passaggi: a. Si connette alla tua istanza Qdrant tramite l'URL fornito. b. Crea una nuova "collezione" (l'equivalente di una tabella in un database SQL) se non esiste. c. Chiama il clientOpenAIEmbeddingsper vettorizzare i documenti. d. Inserisce i documenti e i loro vettori nella collezione Qdrant. force_recreate=True: Per questo tutorial, utilizziamo questo parametro per assicurarci che la collezione sia vuota ad ogni esecuzione. In produzione, lo imposterebbe aFalseper conservare i tuoi dati.
- Il resto del pipeline (configurazione del LLM, creazione della catena
RetrievalQA) è identico, il che dimostra la flessibilità di LangChain: basta cambiare la fonte delretriever(il cercatore di informazioni) per passare da FAISS a Qdrant.
Per questo tutorial, avrai bisogno di un'istanza di Qdrant. Puoi avviarla facilmente con Docker:
# 1. Télécharger la dernière image de Qdrant
docker pull qdrant/qdrant

# 2. Démarrer le conteneur Qdrant
docker run -p 6333:6333 -p 6334:6334 qdrant/qdrant
Il codice sottostante mostra come adattare il pipeline RAG per utilizzare Qdrant come database vettoriale. I documenti di dimostrazione sono brevi; per i tuoi documenti, applica una suddivisione preventiva come nel tutorial FAISS.
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_classic.chains import RetrievalQA
from langchain_qdrant import QdrantVectorStore
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitter

# --- Configuration ---
load_dotenv()
API_KEY = os.getenv("LLMAAS_API_KEY")
BASE_URL = os.getenv("API_URL", "https://api.ai.cloud-temple.com/v1")
EMBEDDING_MODEL = "granite-embedding:278m"
LLM_MODEL = "gpt-oss:120b"
QDRANT_URL = os.getenv("QDRANT_URL", "http://localhost:6333")
QDRANT_COLLECTION_NAME = "tutorial_collection"

def setup_qdrant_rag_pipeline():
    """Configure et retourne un pipeline RAG utilisant Qdrant."""
    print("1. Initialisation du client d'embedding LLMaaS...")
    embeddings = OpenAIEmbeddings(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=EMBEDDING_MODEL,
        check_embedding_ctx_length=False,
        model_kwargs={"encoding_format": "float"},
    )

    print("2. Préparation des documents...")
    documents_content = [
        "Cloud Temple est un fournisseur de cloud souverain français avec la qualification SecNumCloud.",
        "Les tarifs publics Cloud Temple sont disponibles sur https://www.cloud-temple.com/nos-tarifs-publics/",
    ]
    documents = [Document(page_content=d) for d in documents_content]

    print(f"3. Connexion à Qdrant et peuplement de la collection '{QDRANT_COLLECTION_NAME}'...")
    vectorstore = QdrantVectorStore.from_documents(
        documents,
        embeddings,
        url=QDRANT_URL,
        collection_name=QDRANT_COLLECTION_NAME,
        force_recreate=True, # Assure une collection propre pour le tutoriel
    )
    print("   -> Collection créée et peuplée avec succès.")

    print(f"4. Configuration du LLM ({LLM_MODEL})...")
    llm = ChatOpenAI(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=LLM_MODEL,
        temperature=0.3
    )

    print("5. Création de la chaîne RAG...")
    qa_chain = RetrievalQA.from_chain_type(
        llm=llm,
        retriever=vectorstore.as_retriever(),
        return_source_documents=True
    )
    print("   -> Pipeline RAG avec Qdrant prêt.")
    return qa_chain

# --- Exécution ---
def main_qdrant():
    """Fonction principale pour exécuter le pipeline RAG avec Qdrant."""
    if not API_KEY:
        print("Erreur: La variable d'environnement LLMAAS_API_KEY n'est pas définie.")
        return

    try:
        rag_chain = setup_qdrant_rag_pipeline()
        question = "Quels sont les tarifs de l'API LLMaaS de Cloud Temple ?"

        print(f"\n--- Interrogation du pipeline ---")
        result = rag_chain.invoke({"query": question})

        print(f"\nQuestion: {question}")
        print(f"Réponse: {result['result']}")
        print("\nSources utilisées pour la réponse:")
        for source in result["source_documents"]:
            print(f"- Contenu: \"{source.page_content}\"")

    except Exception as e:
        print(f"\nUne erreur est survenue: {e}")
        print("Veuillez vous assurer que le conteneur Qdrant est bien en cours d'exécution.")

if __name__ == "__main__":
    main_qdrant()
4. Agenti LangChain con Strumenti
Un agente è un LLM che non si limita a rispondere a una domanda, ma può utilizzare un insieme di strumenti (funzioni, API, ecc.) per costruire una risposta più complessa. Può ragionare, scomporre un problema, scegliere uno strumento, eseguirlo, osservare il risultato e ripetere questo ciclo fino a ottenere una risposta finale.
Il codice spiegato
Questo esempio costruisce un agente semplice in grado di utilizzare due strumenti: uno per interrogare un'API (simulata) di Cloud Temple e un altro per eseguire calcoli.
- Definizione degli Strumenti: Le classi
CloudTempleAPITooleSimpleCalculatorToolereditano daBaseTool. Ogni strumento ha:- Un
name: un nome semplice e descrittivo. - Una
description: cruciale, è ciò che il LLM legge per decidere quale strumento utilizzare. Deve essere molto chiara su cosa fa lo strumento e quando usarlo. - Un metodo
_run: il codice che viene effettivamente eseguito quando l'agente sceglie questo strumento.
- Un
create_agent_with_tools:- Inizializzazione del LLM: Utilizziamo il nostro wrapper
CloudTempleLLMdefinito nel primo tutorial. - Lista degli strumenti: Forniamo all'agente la lista degli strumenti che ha il diritto di utilizzare.
- Prompt dell'agente: Il prompt è molto specifico. Si tratta di un "prompt di ragionamento" che istruisce il LLM su come pensare (
Thought), scegliere un'azione (Action), fornire un input a questa azione (Action Input) e osservare il risultato (Observation). È il meccanismo centrale del framework ReAct (Reasoning and Acting) utilizzato qui. - Creazione dell'agente:
create_react_agentassembla il LLM, gli strumenti e il prompt per creare l'agente. AgentExecutor: È il motore che fa girare l'agente in loop finché non produce unaFinal Answer. Il parametroverbose=Trueè molto utile per vedere il "dialogo interiore" dell'agente (i suoi pensieri, le sue azioni, ecc.).
- Inizializzazione del LLM: Utilizziamo il nostro wrapper
from langchain_classic.agents import AgentExecutor, create_react_agent
from langchain_core.tools import BaseTool
from langchain_core.prompts import PromptTemplate
import requests
import json
import os

# (La classe CloudTempleLLM est la même que dans le premier exemple)

# --- Définition des Outils ---

class CloudTempleAPITool(BaseTool):
    """Un outil qui simule un appel à une API interne pour obtenir des informations sur les services."""
    name: str = "cloud_temple_api_checker"
    description: str = "Utile pour obtenir des informations sur les services, produits et offres de Cloud Temple."

    def _run(self, query: str) -> str:
        # Dans un cas réel, ceci appellerait une véritable API.
        print(f"--- Outil CloudTempleAPITool appelé avec la requête: '{query}' ---")
        if "service" in query.lower():
            return "Cloud Temple propose les services suivants : IaaS, PaaS, LLMaaS, Sécurité Managée."
        return "Information non trouvée."

    async def _arun(self, query: str) -> str:
        # Implémentation asynchrone non nécessaire pour cet exemple.
        raise NotImplementedError("L'outil API ne supporte pas l'exécution asynchrone.")

class SimpleCalculatorTool(BaseTool):
    """Un outil simple pour effectuer des calculs mathématiques."""
    name: str = "simple_calculator"
    description: str = (
        "Effectue une opération entre deux nombres, séparés par des espaces : "
        "par exemple '125 * 8'. Opérateurs autorisés : +, -, *, /. "
        "Pour un calcul composé, appeler l'outil plusieurs fois."
    )

    def _run(self, expression: str) -> str:
        import math
        import operator

        operations = {
            "+": operator.add,
            "-": operator.sub,
            "*": operator.mul,
            "/": operator.truediv,
        }
        try:
            if len(expression) > 100:
                raise ValueError("Entrée trop longue.")
            left, symbol, right = expression.split()
            if symbol not in operations:
                raise ValueError("Opérateur autorisé : +, -, * ou /.")
            left, right = float(left), float(right)
            if not (math.isfinite(left) and math.isfinite(right)):
                raise ValueError("Les nombres doivent être finis.")
            result = operations[symbol](left, right)
            if not math.isfinite(result):
                raise ValueError("Résultat hors limites.")
            return str(result)
        except (ValueError, OverflowError, ZeroDivisionError) as e:
            return f"Erreur de calcul: {e}"

    async def _arun(self, expression: str) -> str:
        raise NotImplementedError("L'outil Calculatrice ne supporte pas l'exécution asynchrone.")

# --- Création de l'Agent ---

def create_agent():
    """Configure et retourne un agent LangChain avec les outils définis."""
    print("1. Initialisation du LLM pour l'agent...")
    llm = CloudTempleLLM(api_key=os.getenv("LLMAAS_API_KEY", "votre-clé-api-ici"))

    tools = [CloudTempleAPITool(), SimpleCalculatorTool()]

    # Le template de prompt est crucial : il guide le LLM dans son raisonnement.
    template = """
    Réponds aux questions suivantes du mieux que tu peux. Tu as accès aux outils suivants :

    {tools}

    Utilise le format suivant :

    Question: la question à laquelle tu dois répondre
    Thought: tu dois toujours réfléchir à ce que tu vas faire
    Action: l'action à prendre, doit être l'un de [{tool_names}]
    Action Input: l'entrée de l'action
    Observation: le résultat de l'action
    ... (cette séquence Thought/Action/Action Input/Observation peut se répéter)
    Thought: Je connais maintenant la réponse finale.
    Final Answer: la réponse finale à la question d'origine

    Commence !

    Question: {input}
    Thought:{agent_scratchpad}
    """

    prompt = PromptTemplate.from_template(template)

    print("2. Création de l'agent avec le framework ReAct...")
    agent = create_react_agent(llm, tools, prompt)

    # L'AgentExecutor est responsable de l'exécution des cycles de l'agent.
    agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True)
    print("   -> Agent prêt.")
    return agent_executor

# --- Exécution ---

def run_agent():
    """Exécute l'agent avec différentes questions pour tester ses capacités."""
    if os.getenv("LLMAAS_API_KEY") is None:
        print("Veuillez configurer votre LLMAAS_API_KEY.")
        return

    agent_executor = create_agent()

    print("\n--- Test 1 : Question nécessitant un outil d'information ---")
    question1 = "Quels sont les services offerts par Cloud Temple ?"
    response1 = agent_executor.invoke({"input": question1})
    print(f"\nRéponse finale de l'agent: {response1['output']}")

    print("\n--- Test 2 : Question nécessitant un calcul ---")
    question2 = "Quel est le résultat de 125 * 8 + 50 ?"
    response2 = agent_executor.invoke({"input": question2})
    print(f"\nRéponse finale de l'agent: {response2['output']}")

if __name__ == "__main__":
    run_agent()
5. Integrazione SDK OpenAI
Configurazione dell'SDK OpenAI per LLMaaS
Questo esempio utilizza le chiamate supportate da LLMaaS. Per adattare un'applicazione esistente, consulta le differenze documentate.
from openai import OpenAI

# Configuration pour Cloud Temple LLMaaS
def setup_cloud_temple_client():
    """Configuration client OpenAI pour Cloud Temple"""

    client = OpenAI(
        api_key="your-cloud-temple-api-key",
        base_url="https://api.ai.cloud-temple.com/v1"
    )

    return client

def test_openai_compatibility():
    """Test de compatibilité avec SDK OpenAI"""

    client = setup_cloud_temple_client()

    # Chat completion standard
    response = client.chat.completions.create(
        model="gpt-oss:120b",
        messages=[
            {"role": "system", "content": "Tu es un assistant IA professionnel."},
            {"role": "user", "content": "Explique-moi l'architecture cloud native."}
        ],
        max_tokens=300,
        temperature=0.7
    )

    print(f"Réponse: {response.choices[0].message.content}")

    # Streaming
    stream = client.chat.completions.create(
        model="gpt-oss:120b",
        messages=[
            {"role": "user", "content": "Écris un poème sur l'IA."}
        ],
        stream=True,
        max_tokens=200
    )

    print("Stream:")
    for chunk in stream:
        if chunk.choices[0].delta.content is not None:
            print(chunk.choices[0].delta.content, end="")
    print()

# Test de compatibilité
test_openai_compatibility()
5. Integrazione Semantic Kernel (Microsoft)
Semantic Kernel è un SDK open-source di Microsoft che permette di integrare LLM in applicazioni .NET, Python e Java. Sebbene sia ottimizzato per i servizi Azure OpenAI, la sua flessibilità permette di utilizzarlo con qualsiasi API compatibile OpenAI, inclusa la nostra.
Il codice spiegato
Questo esempio non richiede l'SDK Semantic Kernel completo. Dimostra come il concetto di "funzione semantica" può essere implementato con una semplice chiamata alla nostra API. Una funzione semantica è essenzialmente un prompt strutturato inviato a un LLM per completare un compito specifico.
semantic_kernel_simple(): Questa funzione simula una "funzione di riassunto".- Prompt Strutturato: Utilizziamo un messaggio
systemper assegnare un ruolo al LLM ("Sei un esperto di riassunti.") e un messaggiousercontenente il testo da riassumere. È il cuore del concetto di funzione semantica. - Chiamata API Diretta: Una semplice chiamata
requests.postal nostro endpoint/v1/chat/completionsè sufficiente per eseguire la funzione.
Questo esempio illustra che non è sempre necessario utilizzare un framework pesante. Per compiti semplici e ben definiti, una chiamata diretta all'API LLMaaS è spesso la soluzione più efficiente e performante.
import requests
import os
from dotenv import load_dotenv

def semantic_kernel_simulation():
    """
    Simule une "fonction sémantique" de résumé en appelant directement l'API LLMaaS.
    """
    load_dotenv()
    api_key = os.getenv("LLMAAS_API_KEY")
    if not api_key:
        print("Veuillez définir la variable d'environnement LLMAAS_API_KEY.")
        return

    headers = {
        "Authorization": f"Bearer {api_key}",
        "Content-Type": "application/json"
    }

    text_to_summarize = """
    L'intelligence artificielle (IA) transforme de nombreux secteurs industriels en automatisant les tâches,
    en optimisant les processus et en permettant des analyses prédictives avancées.
    Cloud Temple, avec son offre LLMaaS souveraine et certifiée SecNumCloud, permet aux entreprises
    d'intégrer ces capacités d'IA tout en garantissant la sécurité et la confidentialité de leurs données.
    """

    # Le prompt combine une instruction (rôle système) et des données (rôle utilisateur)
    payload = {
        "model": "gpt-oss:120b",
        "messages": [
            {"role": "system", "content": "Tu es un assistant expert en synthèse de documents techniques."},
            {"role": "user", "content": f"Résume le texte suivant en une seule phrase concise: {text_to_summarize}"}
        ],
        "max_tokens": 100,
        "temperature": 0.5
    }

    try:
        response = requests.post(
            "https://api.ai.cloud-temple.com/v1/chat/completions",
            headers=headers,
            json=payload,
            timeout=30
        )
        response.raise_for_status()
        result = response.json()
        summary = result['choices'][0]['message']['content']

        print("Texte original:\n", text_to_summarize)
        print("\nRésumé généré:\n", summary)
        return summary

    except requests.exceptions.RequestException as e:
        print(f"Une erreur d'API est survenue: {e}")

if __name__ == "__main__":
    semantic_kernel_simulation()
6. Framework Haystack
Haystack è un altro potente framework open-source per costruire applicazioni di ricerca semantica, RAG e agenti. Come per Semantic Kernel, la nostra API può essere integrata direttamente.
Il codice spiegato
Questo esempio simula un "pipeline" Haystack di base per la ricerca di risposte in un contesto dato (Question Answering).
process_with_context: Questa funzione rappresenta il cuore di un pipeline di QA. Prende uncontexto(ad esempio, un paragrafo di documento) e unaquestion.- Prompt Contestuale : Il prompt è accuratamente strutturato per includere sia il contesto che la domanda. È una tecnica fondamentale in RAG: si forniscono al LLM le informazioni pertinenti affinché possa formulare una risposta fattuale.
- Chiamata API : Ancora una volta, una semplice chiamata
requests.postalla nostra API è sufficiente. Il LLM riceve il contesto e la domanda, e il suo compito è sintetizzare una risposta basata esclusivamente sulle informazioni fornite.
Questo esempio illustra la flessibilità dell'API LLMaaS, che può fungere da mattone di base per la generazione di testo in qualsiasi framework, anche per quelli per i quali non esiste un'integrazione ufficiale.
import requests
import os
from dotenv import load_dotenv

def haystack_simulation():
    """
    Simule un pipeline de Question-Answering de type Haystack
    en utilisant un appel direct à l'API LLMaaS.
    """
    load_dotenv()
    api_key = os.getenv("LLMAAS_API_KEY")
    if not api_key:
        print("Veuillez définir la variable d'environnement LLMAAS_API_KEY.")
        return

    headers = {
        "Authorization": f"Bearer {api_key}",
        "Content-Type": "application/json"
    }

    # Le contexte est l'information que le LLM est autorisé à utiliser.
    context = """
    Un cloud souverain est une infrastructure de cloud computing qui est entièrement contenue
    dans les frontières d'un pays spécifique et soumise à ses lois.
    Les principaux avantages sont la garantie de la résidence des données, la conformité avec
    les réglementations locales (comme le RGPD en Europe), et une protection accrue contre
    l'accès par des entités étrangères en vertu de lois extraterritoriales comme le CLOUD Act américain.
    """

    question = "Quels sont les avantages d'un cloud souverain ?"

    # Le prompt guide le LLM pour qu'il base sa réponse sur le contexte fourni.
    prompt = f"""
    En te basant uniquement sur le contexte suivant, réponds à la question.

    Contexte:
    ---
    {context}
    ---

    Question: {question}
    """

    payload = {
        "model": "gpt-oss:120b",
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 200,
        "temperature": 0.2 # Température basse pour une réponse factuelle
    }

    try:
        response = requests.post(
            "https://api.ai.cloud-temple.com/v1/chat/completions",
            headers=headers,
            json=payload,
            timeout=30
        )
        response.raise_for_status()
        result = response.json()
        answer = result['choices'][0]['message']['content']

        print(f"Question: {question}")
        print("\nRéponse générée:\n", answer)
        return answer

    except requests.exceptions.RequestException as e:
        print(f"Une erreur d'API est survenue: {e}")

if __name__ == "__main__":
    haystack_simulation()
7. Integrazione LlamaIndex
LlamaIndex è un framework specializzato nella costruzione di applicazioni RAG. Offre componenti di alto livello per l'ingestione di dati, l'indicizzazione e l'interrogazione. La nostra API, essendo compatibile con l'interfaccia OpenAI, si integra molto facilmente.
Il codice spiegato
Questo esempio mostra come configurare LlamaIndex per utilizzare l'API LLMaaS per la generazione di testo, utilizzando contemporaneamente un modello di embedding locale per la vettorizzazione.
setup_and_run_llamaindex: Questa funzione unica orchestra l'intero processo.- Configurazione del LLM : LlamaIndex fornisce una classe
OpenAILikeche permette di connettersi a qualsiasi API che rispetti il formato OpenAI. Basta fornirle il nostroapi_basee unaapi_key. È il metodo più semplice per rendere il nostro LLM compatibile. - Configurazione degli Embedding : Per questo esempio, utilizziamo un modello di embedding locale (
HuggingFaceEmbedding). Questo mostra la flessibilità di LlamaIndex, che permette di mescolare i componenti. Settings: L'oggettoSettingsdi LlamaIndex è un modo pratico per configurare i componenti predefiniti (LLM, modello di embedding, dimensione dei chunk, ecc.) che verranno utilizzati dagli altri oggetti LlamaIndex.- Ingestione dei dati :
SimpleDirectoryReadercarica i documenti da una cartella. - Creazione dell'indice :
VectorStoreIndex.from_documentsè il metodo di alto livello di LlamaIndex. Gestisce automaticamente il frammentazione in chunk, la vettorizzazione dei chunk (utilizzando l'embed_modelconfigurato inSettings), e la creazione dell'indice in memoria. - Motore di query :
.as_query_engine()crea un'interfaccia semplice per porre domande al nostro indice. Quando si chiama.query(), il motore vettorizza la domanda, trova i documenti più pertinenti nell'indice, e li invia al LLM (configurato inSettings) insieme alla domanda per generare una risposta.
- Configurazione del LLM : LlamaIndex fornisce una classe
# Dépendances:
# pip install llama-index llama-index-llms-openai-like llama-index-embeddings-huggingface

import os
from dotenv import load_dotenv
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader, Settings
from llama_index.llms.openai_like import OpenAILike
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from tempfile import TemporaryDirectory

def setup_and_run_llamaindex():
    """
    Configure et exécute un pipeline RAG simple avec LlamaIndex et l'API LLMaaS.
    """
    load_dotenv()
    api_key = os.getenv("LLMAAS_API_KEY")
    if not api_key:
        print("Veuillez définir la variable d'environnement LLMAAS_API_KEY.")
        return

    # 1. Configuration du LLM pour utiliser l'API LLMaaS via l'interface OpenAILike
    print("1. Configuration du LLM pour pointer vers l'API LLMaaS...")
    llm = OpenAILike(
        api_key=api_key,
        api_base="https://api.ai.cloud-temple.com/v1",
        model="gpt-oss:120b",
        is_chat_model=True,
        # Il est parfois nécessaire d'ajouter des paramètres de contexte pour certains modèles
        # context_window=3900,
    )

    # 2. Configuration du modèle d'embedding (local dans cet exemple pour la simplicité)
    print("2. Configuration du modèle d'embedding local...")
    embed_model = HuggingFaceEmbedding(
        model_name="sentence-transformers/all-MiniLM-L6-v2"
    )

    # 3. Application des configurations globales via l'objet Settings de LlamaIndex
    Settings.llm = llm
    Settings.embed_model = embed_model
    print("   -> LLM et modèle d'embedding configurés.")

    # 4. Création d'une base de connaissances simple dans un répertoire temporaire
    print("4. Création et chargement d'une base de connaissances temporaire...")
    with TemporaryDirectory(prefix="llmaas_llamaindex_") as temp_dir:
        knowledge_file = os.path.join(temp_dir, "knowledge.txt")
        with open(knowledge_file, "w", encoding="utf-8") as f:
            f.write("L'offre LLMaaS de Cloud Temple est une solution d'IA générative souveraine, "
                    "entièrement opérée en France et qualifiée SecNumCloud par l'ANSSI.")

        documents = SimpleDirectoryReader(temp_dir).load_data()
        print(f"   -> {len(documents)} document(s) chargé(s).")
    # Les documents sont en mémoire ; le dossier temporaire est supprimé,
    # y compris si l'écriture ou le chargement échoue.

    # 5. Création de l'index vectoriel. LlamaIndex gère le chunking et l'embedding.
    print("5. Création de l'index vectoriel...")
    index = VectorStoreIndex.from_documents(documents)
    print("   -> Index créé.")

    # 6. Création du moteur de requête et interrogation de la base de connaissances
    print("6. Création du moteur de requête et interrogation...")
    query_engine = index.as_query_engine()
    question = "Quelles sont les garanties de souveraineté de l'offre LLMaaS ?"
    response = query_engine.query(question)

    print(f"\nQuestion: {question}")
    print(f"Réponse: {response}")


if __name__ == "__main__":
    setup_and_run_llamaindex()
8. Configurazione dell'estensione CLINE per VSCode
Questo tutorial ti guida nella configurazione dell'estensione CLINE in Visual Studio Code per utilizzare i modelli di linguaggio di Cloud Temple direttamente dal tuo editor.
Passaggi di configurazione
-
Aprire le impostazioni di CLINE : In VSCode, apri le impostazioni dell'estensione CLINE.
-
Creare un nuovo modello : Aggiungi una nuova configurazione del modello.
-
Compilare i campi : Configura i campi come segue, basandoti sull'immagine sottostante.
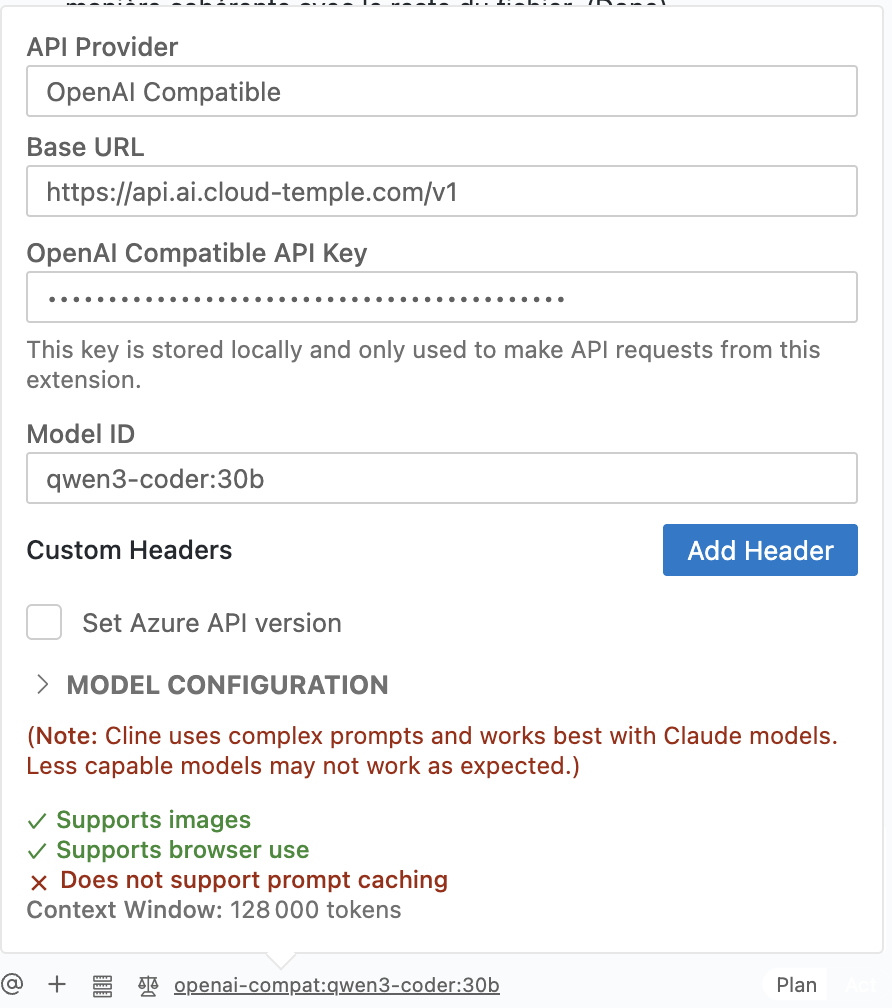
- API Provider: Seleziona
OpenAI Compatible. - Base URL: Inserisci l'endpoint dell'API LLMaaS di Cloud Temple:
https://api.ai.cloud-temple.com/v1. - OpenAI Compatible API Key: Incolla la chiave API che hai generato dalla console Cloud Temple.
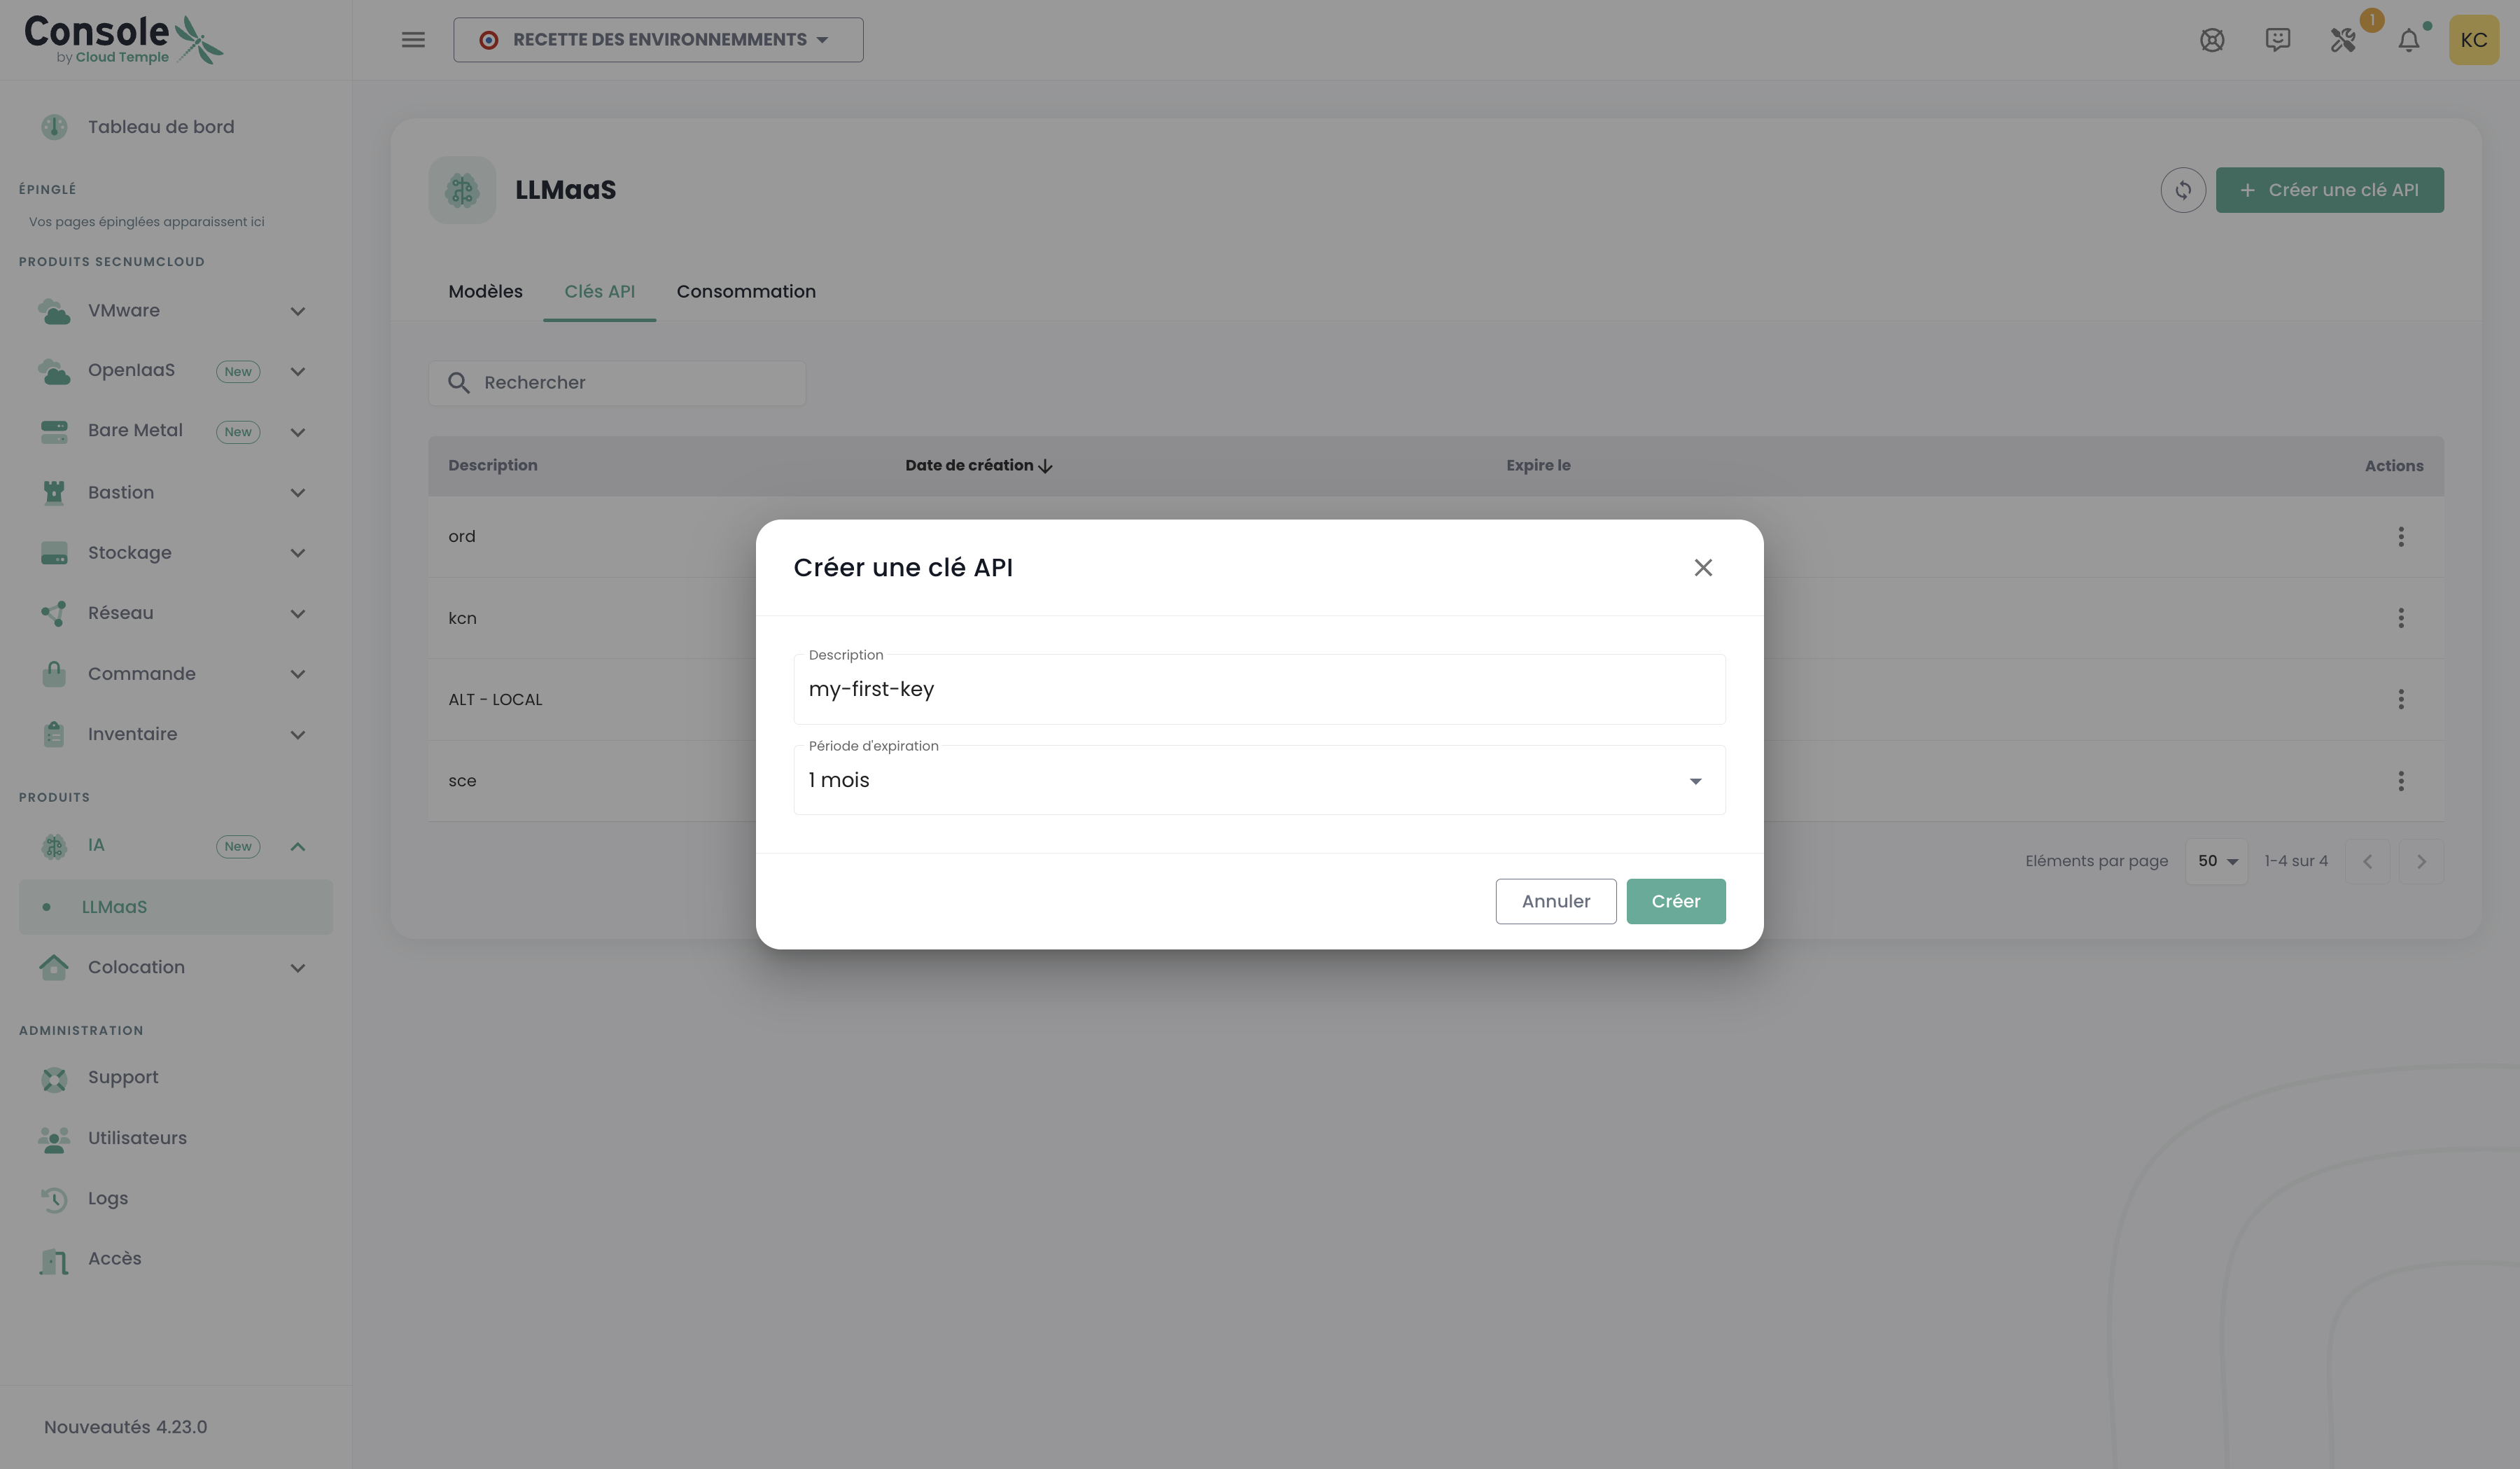
Generazione della chiave APIPer generare la tua chiave API, vai nella console Cloud Temple, sezione LLMaaS > Chiavi API, e clicca su "Crea una chiave API".
- Model ID: Specifica il modello che desideri utilizzare, ad esempio
qwen3.6:35b. Puoi trovare l'elenco dei modelli disponibili nella sezione Modelli. - Model Configuration:
- Supports Images: Spunta questa casella se il modello supporta le immagini.
- Supports browser use: Spunta questa casella.
- Context Window Size: Indica la dimensione della finestra di contesto del modello (es:
128000). - Max Output Tokens: Lascia a
-1per un'uscita non limitata di default. - Temperature: Regola la temperatura in base alle tue esigenze (es:
0).
- API Provider: Seleziona
Ora puoi selezionare un modello in CLINE e utilizzarlo per generare codice, rispondere a domande, ecc.
💡 Esempi Avanzati
Troverete nella cartella GitHub sottostante una raccolta di esempi di codice e script che dimostrano le diverse funzionalità e casi d'uso dell'offerta LLM as a Service (LLMaaS) di Cloud Temple :
Cloud-Temple/product-llmaas-how-to
Troverete guide pratiche per :
-
Estrazione di Informazioni e Analisi del Testo : Capacità di analizzare documenti per estrarre dati strutturati come entità, eventi, relazioni e attributi, basandosi su ontologie specifiche per dominio (es: legale, HR, IT).
-
Interazione Conversazionale e Chatbot : Sviluppo di agenti conversazionali in grado di dialogare, mantenere una cronologia degli scambi, utilizzare istruzioni di sistema (prompt di sistema) e invocare strumenti esterni.
-
Trascrizione Audio (Speech-to-Text) : Conversione di contenuti audio in testo, incluso per file di grandi dimensioni, grazie a tecniche di segmentazione, normalizzazione ed elaborazione batch.
-
Traduzione del Testo : Traduzione di documenti da una lingua all'altra, gestendo il contesto su più segmenti per migliorare la coerenza.
-
Gestione e Valutazione dei Modelli : Elenco dei modelli linguistici disponibili tramite l'API, consultazione delle loro specifiche ed esecuzione di test per confrontarne le prestazioni.
-
Streaming delle Risposte in Tempo Reale : Dimostrazione della capacità di ricevere e visualizzare le risposte dei modelli in modo progressivo (token per token), essenziale per le applicazioni interattive.
-
Pipeline RAG con Database di Conoscenza in Memoria : Demo RAG didattico per illustrare il funzionamento del Retrieval-Augmented Generation. Utilizza l'API LLMaaS per l'embedding e la generazione, con memorizzazione dei vettori in memoria (FAISS) per una chiara comprensione del processo.
-
Pipeline RAG con Database Vettoriale (Qdrant) : Demo RAG completa e containerizzata che utilizza Qdrant come database vettoriale. L'API LLMaaS viene utilizzata per l'embedding dei documenti e la generazione di risposte arricchite.
-
OCR & Analisi dei Documenti (DeepSeek-OCR) : Guida completa e strumento di dimostrazione per convertire immagini e PDF in Markdown strutturato, estrarre tabelle e trascrivere formule matematiche. Vedere la documentazione dedicata.