Guida: Padroneggiare l'OCR con DeepSeek
Questa guida dettagli l'utilizzo del modello DeepSeek-OCR, una soluzione all'avanguardia per la compressione ottica del contesto e l'analisi dei documenti.
Questa guida descrive l'integrazione di DeepSeek-OCR. Prima di utilizzarlo, verificare che il modello sia esposto da GET /v1/models e consultare il catalogo e ciclo di vita. Se non è disponibile, selezionare un modello di visione adatto e utilizzare il formato di richiesta corrispondente; i parametri specifici di questa guida non sono universali.
Architettura e funzionamento
A differenza degli OCR tradizionali, DeepSeek-OCR è un modello Vision-Language end-to-end progettato per "leggere" e "comprendere" visivamente i documenti.
Architettura tecnica
Combina due componenti innovativi:
- DeepEncoder (380M): Un encoder visivo ibrido che combina SAM-base (per la percezione locale) e CLIP-large (per la conoscenza globale), collegati da un compressore convoluzionale 16x. Ciò consente di elaborare immagini ad alta risoluzione con molto pochi token visivi.
- Decodificatore MoE (3B): Basato su DeepSeek3B-MoE (570M parametri attivi), genera il testo strutturato dai token visivi compressi.
Modalità di risoluzione e consumo
Il modello adatta il suo consumo di token alla risoluzione dell'immagine. Più l'immagine è grande, più consuma token, ma migliore è la precisione.
| Modalità | Risoluzione (px) | Token Visivi | Uso Raccomandato |
|---|---|---|---|
| Tiny | 512 x 512 | 64 | Slide, testo molto grande |
| Small | 640 x 640 | 100 | Documenti semplici, ricevute |
| Base | 1024 x 1024 | 256 | Pagine A4 standard |
| Large | 1280 x 1280 | 400 | Documenti densi, caratteri piccoli |
| Gundam | Dinamico | ~800 | Giornali, planimetrie, scansioni complesse |
Per ottimizzare i costi e la latenza, ridimensionare le immagini alla risoluzione minima necessaria affinché il testo rimanga leggibile.
Supporto multilingue
Il modello è stato addestrato su un vasto corpus di documenti multilingue e supporta il riconoscimento di quasi 100 lingue (tra cui francese, inglese, cinese, arabo, ecc.), con o senza preservazione della formattazione.
Guida ai prompt (Prompt engineering)
La qualità del risultato dipende direttamente dal prompt utilizzato. DeepSeek-OCR reagisce a istruzioni specifiche per attivare le sue diverse capacità.
1. OCR standard (Markdown)
Per estrarre il testo con la sua struttura (titoli, paragrafi, tabelle).
Prompt:
Convert the document to markdown.
Risultato: Testo strutturato, tabelle formattate, layout preservato.
2. "Deep parsing" (Figure, grafici, formule)
Per analizzare il contenuto semantico di grafici, formule chimiche o geometriche.
Prompt:
Parse the figure.
Capacità:
- Grafici (Bar/Line/Pie): Converte in tabella HTML o Markdown.
- Formule Chimiche: Converte in formato SMILES.
- Geometria: Descrive gli elementi geometrici.
3. Grounding (localizzazione)
Per trovare le coordinate di un elemento specifico nell'immagine.
Prompt:
Locate <|ref|>elemento da trovare<|/ref|> in the image.
Esempio: Locate <|ref|>Total<|/ref|> in the image.
Risultato: Restituisce le coordinate della bounding box dell'elemento.
4. Rilevamento oggetti
Per elencare e localizzare tutti gli oggetti visibili.
Prompt:
Identify all objects in the image and output them in bounding boxes.
Tutorial di implementazione (Python)
Ecco un esempio completo che mostra come strutturare la chiamata API per utilizzare queste capacità.
Prerequisiti: formato dell'immagine e dipendenze
- Formato: JPEG o PNG.
- Modalità: RGB (nessuna trasparenza Alpha).
- PDF: Devono essere convertiti in immagini in anticipo (150-300 DPI).
- Dimensioni: Si consiglia di ridimensionare le immagini ad altissima risoluzione per evitare errori di limite di dimensione (413 Payload Too Large).
Installare le librerie necessarie:
pip install requests Pillow
Codice: analisi del documento (OCR)
Prendiamo l'esempio di questa ricevuta di cassa svizzera:
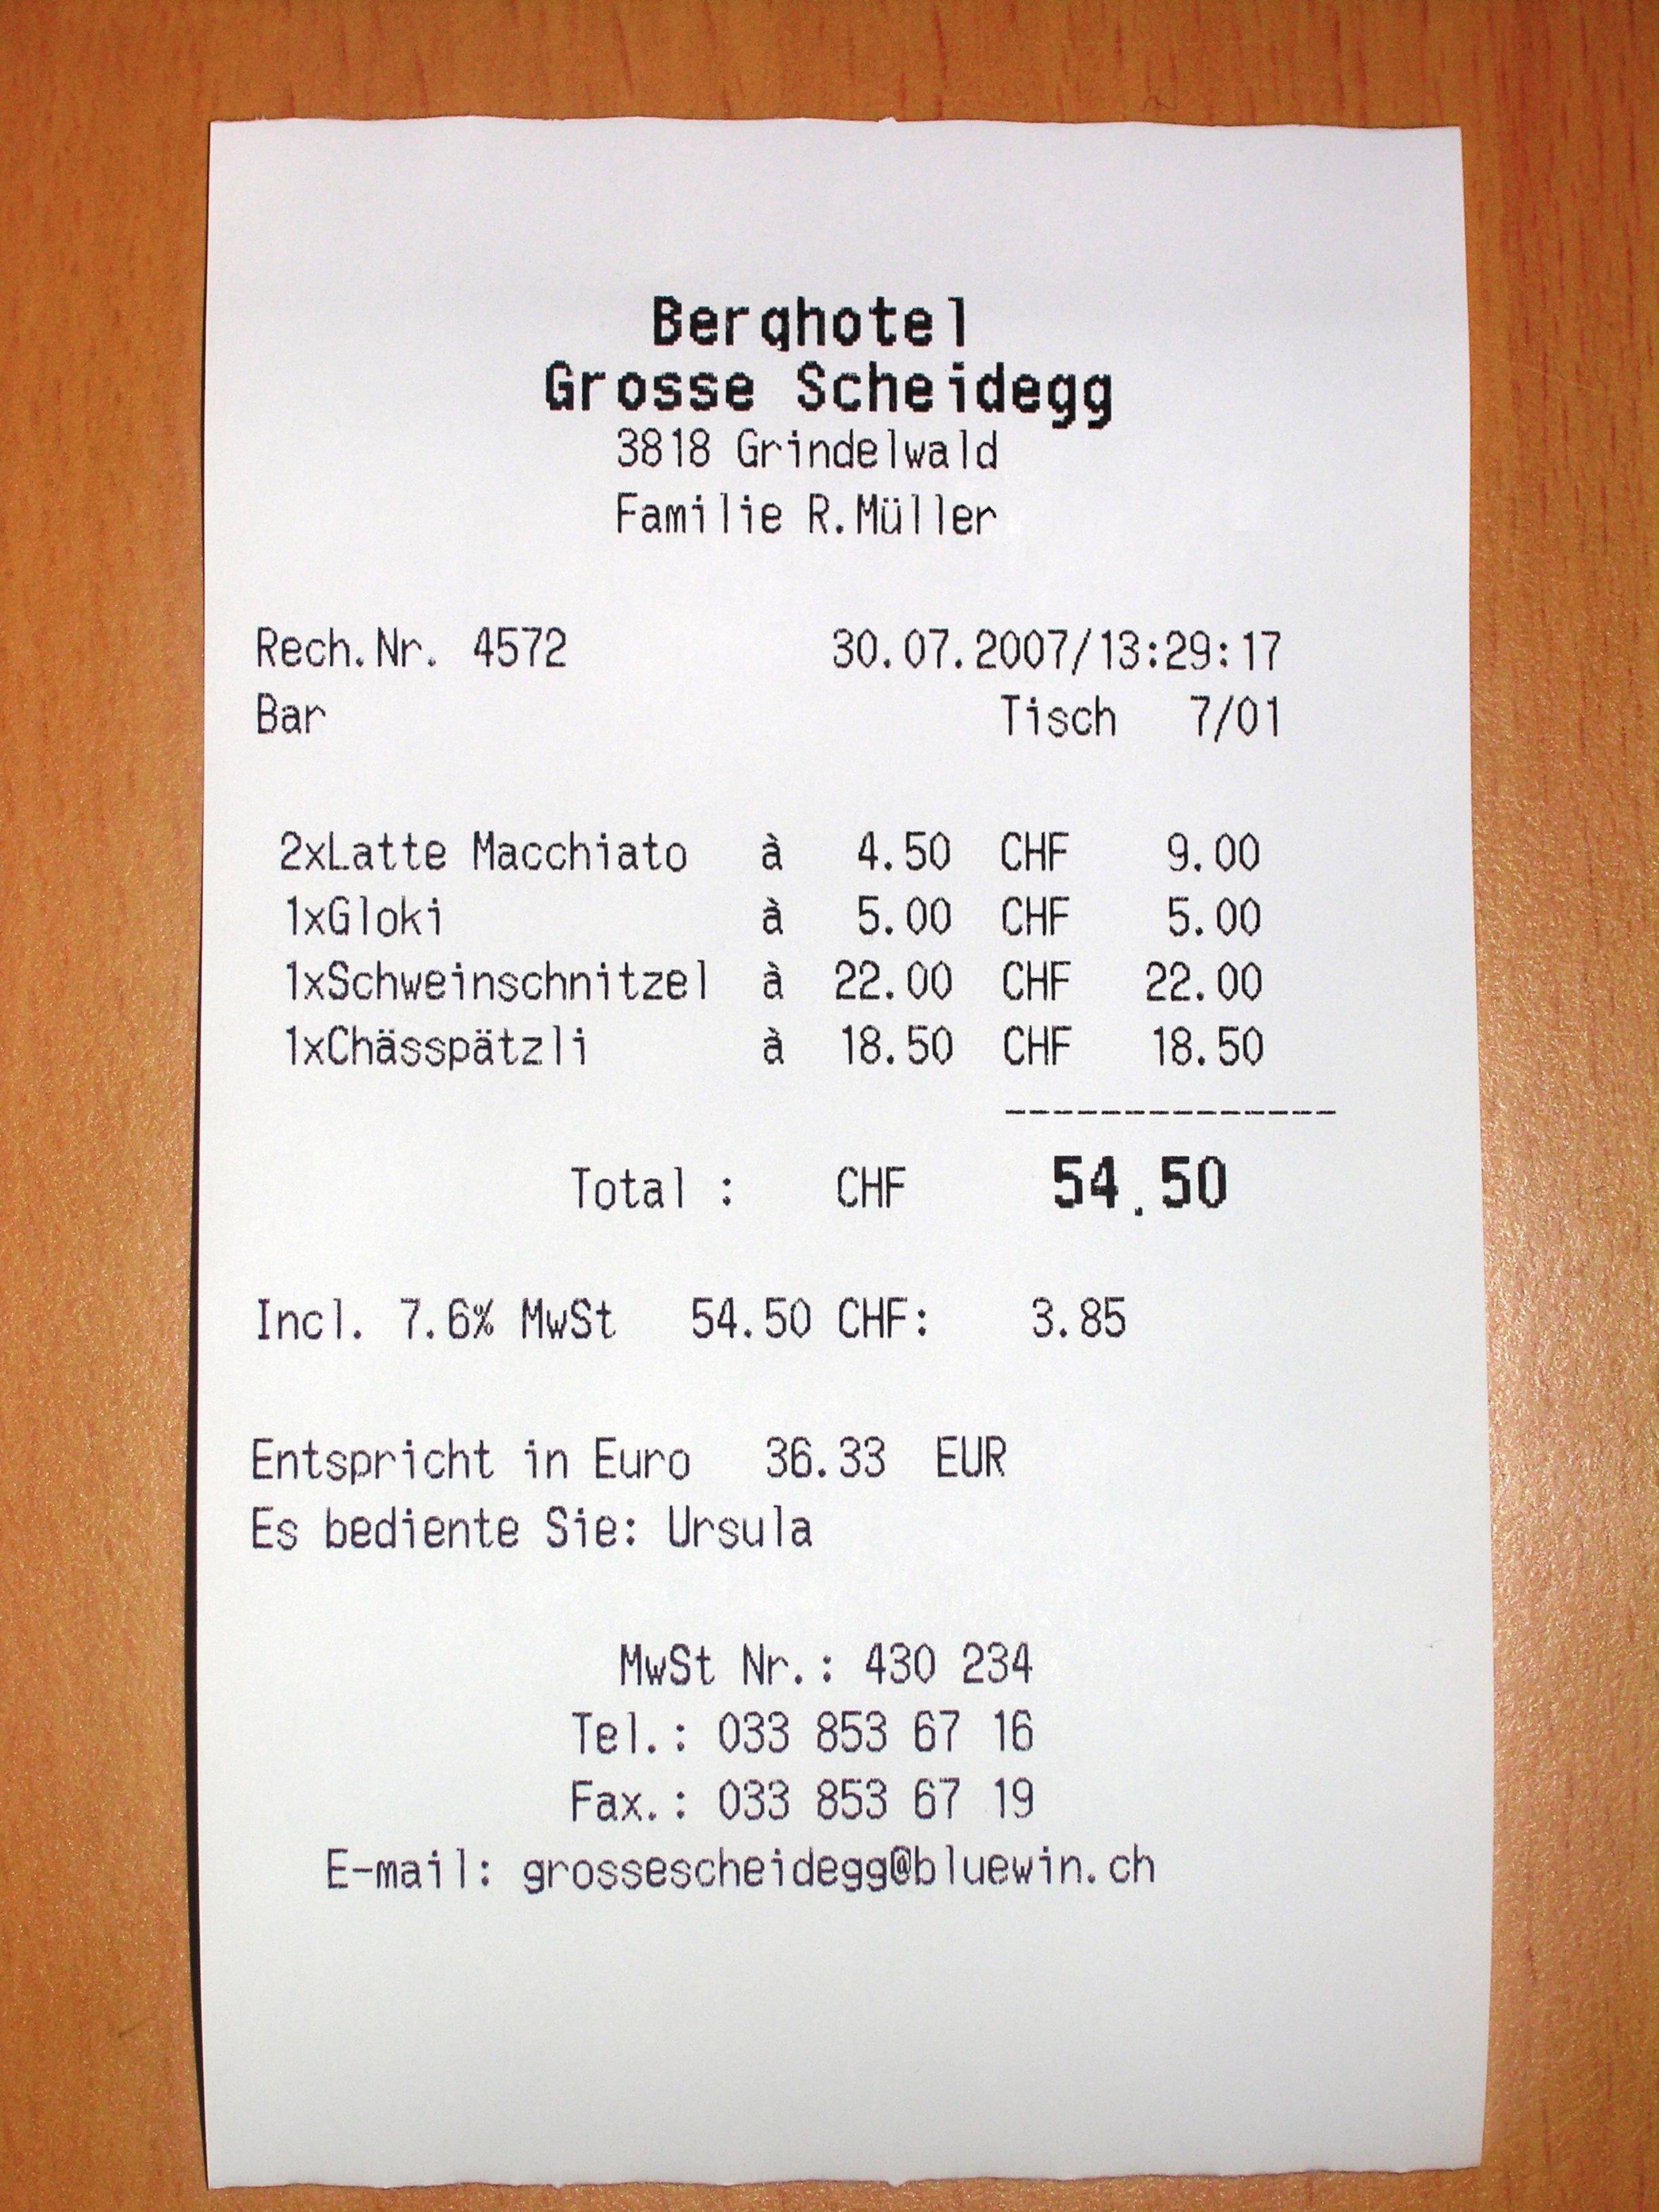
Ecco uno script robusto che gestisce il ridimensionamento e l'encoding ottimale dell'immagine:
import base64
import io
import requests
from PIL import Image

# Configuration
API_KEY = "VOTRE_TOKEN_API"
API_URL = "https://api.ai.cloud-temple.com/v1/chat/completions"
IMAGE_PATH = "ReceiptSwiss.jpg" # Assurez-vous que l'image est dans le dossier courant

def encode_image_optimized(path):
    """
    Optimise l'image (redimensionnement + compression JPEG) pour l'API.
    """
    with Image.open(path) as img:
        # 1. Conversion RGB (pour éviter problèmes PNG/Alpha)
        if img.mode != 'RGB':
            img = img.convert('RGB')

        # 2. Redimensionnement intelligent si trop grand (> 2048px)
        # Cela évite l'erreur 413 (Payload Too Large) et accélère le traitement
        max_size = 2048
        if max(img.size) > max_size:
            img.thumbnail((max_size, max_size))

        # 3. Compression JPEG en mémoire
        buffer = io.BytesIO()
        img.save(buffer, format="JPEG", quality=85)

        return base64.b64encode(buffer.getvalue()).decode('utf-8')

# 1. Construction du message multimodal
encoded_image = encode_image_optimized(IMAGE_PATH)

payload = {
    "model": "deepseek-ai/DeepSeek-OCR",
    "messages": [
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": "Convert the document to markdown." # Prompt OCR Standard
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/jpeg;base64,{encoded_image}"
                    }
                }
            ]
        }
    ],
    "temperature": 0.0, # CRUCIAL : 0.0 pour la fidélité
    "max_tokens": 4096
}

# 2. Envoi
print("Envoi de la requête...")
response = requests.post(
    API_URL,
    headers={"Authorization": f"Bearer {API_KEY}"},
    json=payload
)

# 3. Résultat
if response.status_code == 200:
    print("\n--- Résultat OCR ---\n")
    print(response.json()['choices'][0]['message']['content'])
else:
    print(f"Erreur {response.status_code}: {response.text}")
Esempio di output:
# Berghotel
**Grosse Scheidegg**
3818 Grindelwald
Familie R. Müller

Rech. Nr.  4572
Bar    Tisch   7/01

2xLatte Macchiato    à   4.50 CHF   9.00
1xGloki    à   5.00 CHF   5.00
...

**Total :** CHF **54.50**
**Incl. 7.6% MwSt** 54.50 CHF: 3.85
Codice: analisi del grafico (deep parsing)
Per analizzare un grafico finanziario in un report, cambiare semplicemente il testo del prompt nel payload sopra:
# ... dans le payload ...
"text": "Parse the figure."
# ...
Il modello restituirà una rappresentazione testuale o tabellare dei dati del grafico.
Casi d'uso avanzati
Estrazione di tabelle complesse
DeepSeek-OCR eccelle nella conversione di tabelle, anche senza linee di delimitazione chiare.
Immagine di input — inventario tecnico fittizio:

Questi dati illustrano l'estrazione di una tabella; non definiscono modelli commerciali Cloud Temple.
Output Markdown atteso:
| Équipement | Quantité | vCPU | RAM (Gio) |
|---|---|---|---|
| Serveur web | 2 | 4 | 16 |
| Serveur de calcul | 1 | 8 | 32 |
| Serveur de test | 3 | 2 | 8 |
Per i prezzi pubblici del servizio, consultare il catalogo tariffario ufficiale Cloud Temple.
Formule matematiche (LaTeX)
Ideale per i documenti accademici. Il modello riconosce le equazioni e le restituisce in sintassi LaTeX standard.
Immagine di Input:
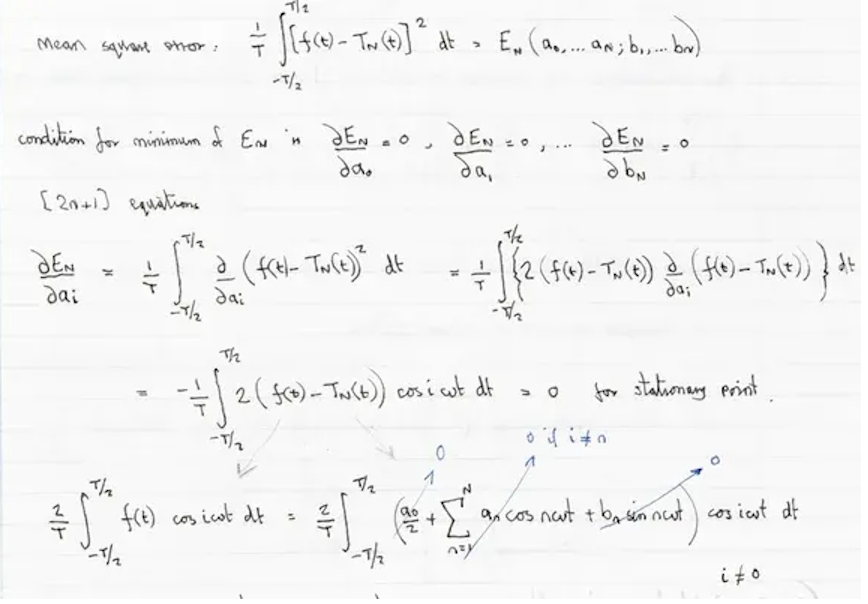
Output del Modello (Prompt: "Convert to latex.") :
Ecco il rendering matematico del risultato OCR:
Mean square error:
Condition for minimum of in:
(2n+1) equations:
Limitazioni note
- Orientamento: Il modello non gestisce la rotazione automatica. Assicurarsi che le immagini siano orientate correttamente (testo orizzontale).
- Testo manoscritto: Sebbene performante, il tasso di errore è più elevato sulla scrittura manoscritta corsiva complessa rispetto al testo stampato.
- Altissima risoluzione: Le immagini che superano le dimensioni della modalità "Gundam" (~2000x2000) vengono ridimensionate, il che può rendere illeggibile il testo microscopico. Tagliare i piani molto grandi in più immagini.