Concetti e Architettura LLMaaS
Panoramica
Il servizio LLMaaS (Large Language Models as a Service) di Cloud Temple fornisce un accesso sicuro e sovrano ai modelli di intelligenza artificiale più avanzati, con la qualifica SecNumCloud dell'ANSSI.
🏗️ Architettura Tecnica
Infrastruttura Cloud Temple
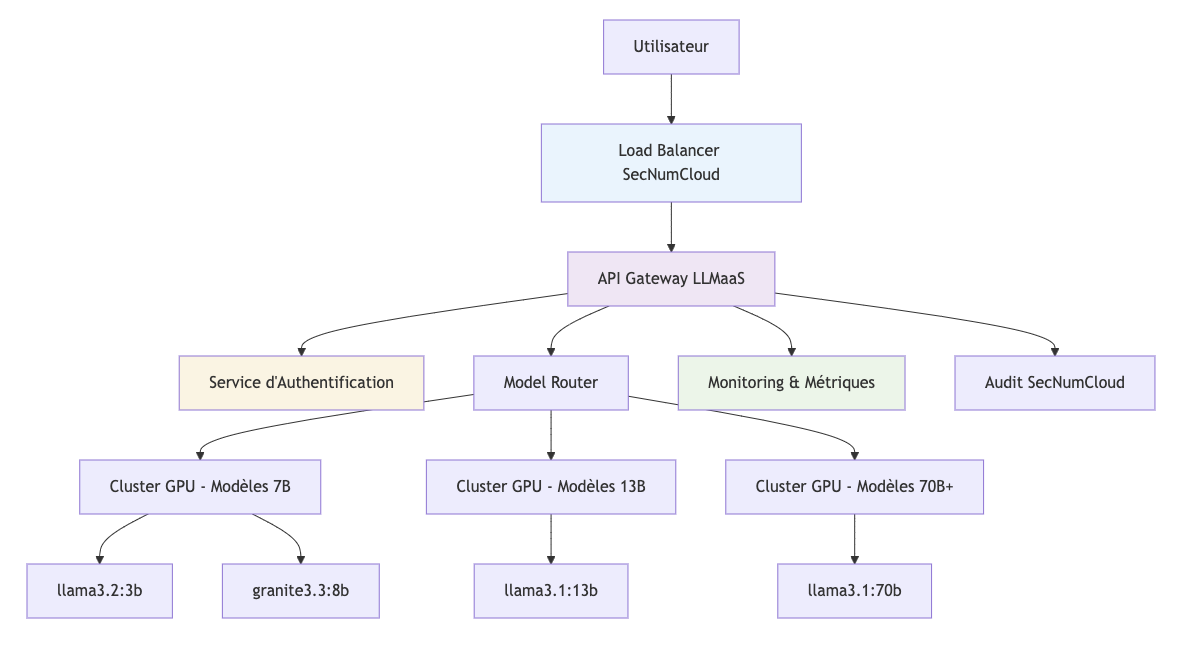
Componenti Principali
1. API Gateway LLMaaS
- Compatibile con OpenAI : Integrazione trasparente con l'ecosistema esistente
- Rate Limiting : Gestione delle quote per livello di fatturazione
- Load Balancing : Distribuzione delle richieste sulle risorse di inferenza
- Monitoring : Metriche in tempo reale e alerting
2. Servizio di Autenticazione
- Chiavi API : Creazione, rotazione e revoca sotto la responsabilità del cliente. Vedi la condivisione delle responsabilità (RACI).
- Controllo degli accessi : Permessi granulari per modello
- Audit trails : Tracciabilità completa degli accessi
🤖 Modelli e Token
Catalogo dei Modelli
Consulta il catalogo e il ciclo di vita e la guida alla scelta.
Gestione dei Token
Tipi di Token
- Token di input : Il tuo prompt e contesto
- Token di output : Risposta generata dal modello
- Token di sistema : Metadata e istruzioni
Calcolo dei Costi
Per conoscere i prezzi pubblici vigenti e creare la tua stima, consulta il catalogo tariffario ufficiale Cloud Temple.
Il costo dipende dai volumi consumati (token, documenti o durata audio) e dalle unità di fatturazione applicabili.
Ottimizzazione
- Context window : Riutilizza le conversazioni per risparmiare
- Modelli appropriati : Scegli la dimensione in base alla complessità
- Max tokens : Limita la lunghezza delle risposte
Tokenizzazione
# Exemple d'estimation de tokens
def estimate_tokens(text: str) -> int:
    """Estimation approximative : 1 token ≈ 4 caractères"""
    return len(text) // 4

prompt = "Expliquez la photosynthèse"
response_max = 200  # tokens max souhaités

estimated_input = estimate_tokens(prompt)  # ~6 tokens
print(f"Tokens estimés : {estimated_input}; limite de sortie : {response_max}")
🔒 Sicurezza e Conformità
Qualifica SecNumCloud
Il servizio LLMaaS è calcolato su un'infrastruttura tecnica che beneficia della qualifica SecNumCloud 3.2 dell'ANSSI, garantendo:
Protezione dei Dati
- Crittografia end-to-end : TLS 1.3 per tutti gli scambi
- Archiviazione sicura : Dati crittografati a riposo (AES-256)
Sovranità Digitale
- Hosting Francia : Datacenter Cloud Temple certificati
- Diritto francese : Conformità RGPD nativa
- Nessuna esposizione : Nessun trasferimento verso cloud stranieri
Audit e Tracciabilità
- Log completi : Tutte le interazioni tracciate
- Retention : Conservazione secondo politiche legali
- Compliance : Rapporti di audit disponibili
Controlli di Sicurezza

Sicurezza dei Prompt
La piattaforma LLMaaS non applica alcun filtraggio automatico del contenuto dei prompt contro le iniezioni o i tentativi di elusione delle istruzioni (jailbreak).
I controlli del contenuto devono essere implementati nella tua applicazione in base al tuo caso d'uso. Puoi chiamare esplicitamente un modello di sicurezza del catalogo per valutare gli input o le risposte. Questi modelli non vengono eseguiti automaticamente sulle richieste indirizzate ad altri modelli.
Definisci i criteri di filtraggio e il trattamento dei risultati con i tuoi team aziendali, quindi testali sui tuoi dati, in particolare per misurare i falsi positivi. La condivisione delle responsabilità specifica i ruoli del cliente e di Cloud Temple.
📈 Performance e Scalabilità
Monitoring in Tempo Reale
Accessibile tramite Console Cloud Temple :
- Metriche di utilizzo per modello
- Grafici di latenza e throughput
- Alert su soglie di performance
- Cronologia delle richieste
🌐 Integrazione ed Ecosistema
Compatibilità OpenAI
Il servizio LLMaaS è compatibile con l'API OpenAI :
# Migration transparente
from openai import OpenAI

# Avant (OpenAI)
client_openai = OpenAI(api_key="sk-...")

# Après (Cloud Temple LLMaaS)
client_ct = OpenAI(
    api_key="votre-token-cloud-temple",
    base_url="https://api.ai.cloud-temple.com/v1"
)

# Code identique !
response = client_ct.chat.completions.create(
    model="gpt-oss:120b",  # Modèle Cloud Temple
    messages=[{"role": "user", "content": "Bonjour"}]
)
Ecosistema Supportato
Framework IA
- ✅ LangChain : Integrazione nativa
- ✅ Haystack : Pipeline di documenti
- ✅ Semantic Kernel : Orchestrazione Microsoft
- ✅ AutoGen : Agent conversazionali
Strumenti di Sviluppo
- ✅ Jupyter : Notebook interattivi
- ✅ Streamlit : Applicazioni web rapide
- ✅ Gradio : Interfacce utente IA
- ✅ FastAPI : API backend
Piattaforme No-Code
- ✅ Zapier : Automazioni
- ✅ Make : Integrazioni visive
- ✅ Bubble : Applicazioni web
🔄 Ciclo di Vita dei Modelli
Il ciclo di vita dei modelli pubblica gli stati, le scadenze e le migrazioni consigliate. Consultalo prima di scegliere un modello e durante l'esecuzione della tua applicazione.
Leggere il ciclo di vita
- DMP : data di messa in produzione.
- DSP : data di uscita dalla produzione (fine del supporto) annunciata per il modello.
- LTS (Long Term Support) : modello che beneficia di un supporto esteso; verifica la data pubblicata per il modello interessato.
- Production : modello indicato in produzione nel catalogo.
- Deprecated : modello deprecato per il quale deve essere preparata una migrazione. Questo stato non significa necessariamente che le chiamate API siano già interrotte.
- Planned : modello annunciato, la cui disponibilità deve essere verificata prima dell'uso.
Gli annunci di aggiunta, reindirizzamento e rimozione sono pubblicati nel changelog del servizio. Per esigenze di stabilità o supporto particolari, contattare il supporto per precisare le modalità applicabili.
Reindirizzamenti e vecchi identificatori
Alcuni vecchi identificatori sono reindirizzati a un modello successore. Una richiesta può quindi continuare a funzionare pur essendo elaborata da un altro modello. La continuità della chiamata API non garantisce risposte identiche, né le stesse capacità, latenze o limiti di contesto.
Migrazione verso un altro modello
- Individua il modello interessato, la scadenza e il successore consigliato nel ciclo di vita.
- Verifica l'identificatore del successore con
GET /v1/modelse le sue capacità: visione, chiamate di strumenti, ragionamento e contesto in base al tuo utilizzo. - Testa il successore su un campione rappresentativo delle tue richieste: qualità, formati di output, strumenti, latenza e consumo.
- Aggiorna il parametro
modelnella configurazione della tua applicazione dopo la convalida, quindi monitora i risultati. - Per gli embedding, prevedi di ricalcolare i vettori e ricostruire l'indice se il modello cambia.
Modelli deprecati
L'elenco e le destinazioni di migrazione sono disponibili nel catalogo del ciclo di vita. Se non è indicata alcuna migrazione, contattare il supporto prima della scadenza per scegliere una soluzione adatta.
💡 Buone Pratiche
Per trarre il massimo vantaggio dall'API LLMaaS, è essenziale adottare strategie di ottimizzazione dei costi, delle prestazioni e della sicurezza.
Ottimizzazione dei Costi
Il controllo dei costi si basa su un utilizzo intelligente dei token e dei modelli.
-
Scelta del Modello : Confronta più modelli su esempi rappresentativi del tuo utilizzo. Tieni quello che soddisfa i tuoi requisiti di qualità e latenza, quindi misura il suo consumo di token. Consulta il catalogo del ciclo di vita per identificare i modelli disponibili e i loro successori. La fatturazione dipende dal tariffario applicabile e dai volumi consumati; la sola dimensione del modello non determina il costo fatturato.
-
Gestione del Contesto : La cronologia della conversazione (
messages) viene inviata ad ogni chiamata, consumando token di input. Per conversazioni lunghe, valuta strategie di riepilogo o di finestraggio per conservare solo le informazioni pertinenti.# Per una conversazione lunga, possiamo riassumere i primi scambi.messages = [{"role": "system", "content": "Sei un assistente IA."},{"role": "user", "content": "Riassunto dei primi 10 scambi..."},{"role": "assistant", "content": "Ok, ho il contesto."},{"role": "user", "content": "Ecco la mia nuova domanda."}] -
Limitazione dei Token di Output : Usa sempre il parametro
max_tokensper evitare risposte eccessivamente lunghe e costose. Fissa un limite ragionabile in base a ciò che ti aspetti.# Richiedere un riassunto di massimo 100 parole.response = client.chat.completions.create(model="gpt-oss:120b",messages=[{"role": "user", "content": "Riassumi questo documento..."}],max_tokens=150, # Margine di sicurezza per ~100 parole)
Performance
La reattività della tua applicazione dipende dal modo in cui gestisci le chiamate all'API.
-
Richieste Asincrone : Per elaborare più richieste senza attendere la fine di ciascuna, usa chiamate asincrone. Questo è particolarmente utile per le applicazioni backend che elaborano un grande volume di richieste simultanee.
import asynciofrom openai import AsyncOpenAIclient = AsyncOpenAI(api_key="...", base_url="...")async def process_prompt(prompt: str):# Elabora una singola richiesta in modo asincronoresponse = await client.chat.completions.create(model="gpt-oss:120b", messages=[{"role": "user", "content": prompt}])return response.choices[0].message.contentasync def batch_requests(prompts: list):# Avvia più attività in parallelo e attende il loro completamentotasks = [process_prompt(p) for p in prompts]return await asyncio.gather(*tasks) -
Streaming per l'Esperienza Utente (UX) : Per le interfacce utente (chatbot, assistenti), lo streaming è essenziale. Permette di visualizzare la risposta del modello parola per parola, dando un'impressione di reattività immediata invece di attendere la risposta completa.
# Visualizza la risposta in tempo reale in un'interfaccia utenteresponse_stream = client.chat.completions.create(model="gpt-oss:120b",messages=[{"role": "user", "content": "Raccontami una storia."}],stream=True)for chunk in response_stream:if chunk.choices[0].delta.content:# Visualizza il pezzo di testo nell'UIprint(chunk.choices[0].delta.content, end="", flush=True)
Sicurezza
La sicurezza della tua applicazione è fondamentale, soprattutto quando si elaborano input utente.
-
Validazione e Sanitizzazione degli Input: Non fidarti mai degli input utente. Prima di inviarli all'API, puliscili per rimuovere eventuali codice potenzialmente dannoso o istruzioni di "prompt injection". Limita anche la loro dimensione per prevenire abusi.
def sanitize_input(user_input: str) -> str:# Esempio semplice: rimuovere i marcatori di codice e limitare la lunghezza.# Librerie più robuste possono essere utilizzate per una sanitizzazione avanzata.cleaned = user_input.replace("`", "").replace("'", "").replace("\"", "")return cleaned[:2000] # Limita la dimensione a 2000 caratteri -
Gestione Robusta degli Errori: Avvolgi sempre le tue chiamate API in blocchi
try...exceptper gestire errori di rete, errori dell'API (es. 429 Rate Limit, 500 Internal Server Error) e fornire un'esperienza utente degradata ma funzionale.from openai import APIError, APITimeoutErrortry:response = client.chat.completions.create(...)except APITimeoutError:# Gestire il caso in cui la richiesta richiede troppo temporeturn "Il servizio richiede più tempo del previsto, si prega di riprovare."except APIError as e:# Gestire errori specifici dell'APIlogger.error(f"Errore API LLMaaS: {e.status_code} - {e.message}")return "Spiacenti, si è verificato un errore con il servizio di IA."except Exception as e:# Gestire tutti gli altri errori (rete, ecc.)logger.error(f"Si è verificato un errore imprevisto: {e}")return "Spiacenti, si è verificato un errore imprevisto."