Tutoriales LLMaaS
Los identificadores utilizados ilustran las integraciones. Verifique su disponibilidad con GET /v1/models, sus capacidades y su ciclo de vida. Ajuste la configuración a su uso; un nombre antiguo puede ser redirigido a un sucesor.
Vista general
Estos tutoriales presentan ejemplos de integración con LLMaaS. El alcance de las verificaciones de los ejemplos de LangChain se especifica a continuación; los resultados y datos de demostración no constituyen medidas de rendimiento del servicio.
🚀 Integraciones de LangChain y Frameworks
Prerrequisitos de LangChain
Los ejemplos de LangChain 1 a 4 y los de la referencia de la API fueron verificados el 7 de septiembre de 2026 con Python 3.13.15 y las siguientes versiones. Instálelos en un entorno dedicado:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install \
  langchain-classic==1.0.8 langchain-core==1.6.2 langchain-openai==1.6.0 \
  langchain-community==0.4.2 langchain-text-splitters==1.1.2 \
  langchain-qdrant==1.1.0 qdrant-client==1.19.0 faiss-cpu==1.15.0 \
  pydantic==2.13.5 python-dotenv==1.2.3 requests==2.34.2 httpx==0.28.1
Estas versiones fijan un entorno de referencia; reevalúe los ejemplos antes de actualizar las dependencias.
Las cadenas históricas LLMChain, RetrievalQA y el agente ReAct de estos tutoriales utilizan langchain-classic, conforme a la guía de migración de LangChain. Esta elección conserva la estructura de los ejemplos existentes; algunas clases emiten advertencias de obsolescencia. Para un nuevo proyecto, consulte las interfaces actuales recomendadas por LangChain.
Verificaciones realizadas: carga de ejemplos, invocación del wrapper, búsqueda y generación con FAISS y Qdrant en memoria, ejecución de una herramienta por el agente, chat y embeddings de la referencia de la API. Las respuestas HTTP de LLMaaS fueron simuladas y los accesos de red bloqueados. Estas verificaciones no validan ni los modelos en producción ni la conexión a un servidor Qdrant remoto.
1. Integración básica con LangChain
Este primer ejemplo muestra cómo integrar nuestra API LLMaaS con el popular framework LangChain creando un "wrapper" personalizado. Un wrapper es una clase que "envuelve" nuestra API para hacerla compatible con los mecanismos internos de LangChain.
El código explicado
El código a continuación define una clase CloudTempleLLM que hereda de la clase base LLM de LangChain. Esto nos permite definir un comportamiento personalizado mientras permanecemos compatibles con el ecosistema LangChain (cadenas, agentes, etc.).
CloudTempleLLM(LLM): Nuestra clase hereda deLLM, lo que nos obliga a implementar ciertos métodos, incluido_call._call(self, prompt: str, ...): Este es el núcleo de nuestro wrapper. Cada vez que LangChain necesite llamar a nuestro modelo de lenguaje, invocará este método. Dentro, formateamos una solicitud HTTP POST estándar con los encabezados correctos (Authorization) y elpayloadesperado por nuestra API/v1/chat/completions.exemple_langchain_wrapper(): Esta función de demostración muestra cómo usar nuestro wrapper. Lo instanciamos, creamos unPromptTemplatepara estructurar nuestra solicitud y los combinamos en unaLLMChain. Cuando ejecutamos la cadena (chain.invoke(...)), LangChain llama internamente al método_callque definimos.
Este enfoque es útil si desea un control total sobre cómo LangChain interactúa con la API, pero es más verboso que usar el cliente ChatOpenAI (ver Referencia de la API).
# Installation des dépendances
# Voir les versions validées dans les prérequis LangChain ci-dessus.

from langchain_core.language_models.llms import LLM
from typing import Optional, List, Any
from pydantic import Field
import requests
import json
import os

# --- Configuration ---
# Il est recommandé de stocker votre clé API dans une variable d'environnement
API_KEY = os.getenv("LLMAAS_API_KEY", "votre-clé-api-ici")
BASE_URL = "https://api.ai.cloud-temple.com/v1"

class CloudTempleLLM(LLM):
    """
    Wrapper LangChain personnalisé pour l'API LLMaaS de Cloud Temple.
    Cette classe permet d'utiliser notre API comme un LLM standard dans LangChain.
    """

    api_key: str = Field(default="")
    model_name: str = Field(default="gpt-oss:120b")
    temperature: float = Field(default=0.7)
    max_tokens: int = Field(default=1000)

    @property
    def _llm_type(self) -> str:
        """Identifiant unique pour notre type de LLM."""
        return "cloud_temple_llmaas"

    def _call(self, prompt: str, stop: Optional[List[str]] = None) -> str:
        """
        La méthode principale qui effectue l'appel à l'API LLMaaS.
        LangChain utilise cette méthode pour chaque requête au modèle.
        """
        headers = {
            "Authorization": f"Bearer {self.api_key}",
            "Content-Type": "application/json"
        }

        payload = {
            "model": self.model_name,
            "messages": [{"role": "user", "content": prompt}],
            "temperature": self.temperature,
            "max_tokens": self.max_tokens
        }

        if stop:
            payload["stop"] = stop

        # Exécution de la requête POST vers l'API
        response = requests.post(
            f"{BASE_URL}/chat/completions",
            headers=headers,
            json=payload,
            timeout=60
        )

        response.raise_for_status()  # Lève une exception en cas d'erreur HTTP
        result = response.json()

        # Retourne le contenu du message de l'assistant
        return result['choices'][0]['message']['content']

# --- Exemple d'utilisation ---
from langchain_classic.chains import LLMChain
from langchain_core.prompts import PromptTemplate

def exemple_langchain_wrapper():
    """Démontre l'utilisation du wrapper LLM avec une chaîne LangChain."""

    # 1. Initialisation de notre LLM personnalisé
    llm = CloudTempleLLM(
        api_key=API_KEY,
        model_name="gpt-oss:120b"
    )

    # 2. Création d'un template de prompt pour structurer les requêtes
    template = """
    Tu es un expert en {domaine}.
    Réponds à cette question de manière détaillée et professionnelle :

    Question: {question}

    Réponse:
    """
    prompt = PromptTemplate(
        input_variables=["domaine", "question"],
        template=template
    )

    # 3. Création d'une chaîne qui combine le prompt et le LLM
    chain = LLMChain(llm=llm, prompt=prompt)

    # 4. Exécution de la chaîne avec des variables spécifiques
    result = chain.invoke({
        "domaine": "cybersécurité",
        "question": "Quelles sont les meilleures pratiques pour sécuriser une API REST ?"
    })

    return result["text"]

# --- Lancement du test ---
if __name__ == "__main__":
    if API_KEY == "votre-clé-api-ici":
        print("Veuillez configurer votre LLMAAS_API_KEY dans vos variables d'environnement.")
    else:
        reponse = exemple_langchain_wrapper()
        print("Réponse de l'expert en cybersécurité :\n")
        print(reponse)
2. RAG (Generación Aumentada por Recuperación) con la API LLMaaS
El RAG es una técnica poderosa que permite a un LLM responder preguntas basándose en una base de conocimientos externa. Este tutorial le guía a través de la creación de un pipeline RAG simple utilizando nuestra API para embeddings y generación, y FAISS, una biblioteca de similitud vectorial, para crear un índice en memoria.
El código explicado
El pipeline se descompone en varias etapas lógicas:
- Configuración: Importamos las bibliotecas necesarias y cargamos nuestra clave API desde las variables de entorno. Definimos los modelos a utilizar:
granite-embedding:278mpara la vectorización ygpt-oss:120bpara la generación. OpenAIEmbeddings: El cliente estándar envía los textos a LLMaaS concheck_embedding_ctx_length=Falsey solicita vectores numéricos conencoding_format="float". La división de los documentos se realiza antes de la llamada; consulte los ajustes de embeddings.setup_rag_pipeline: Esta función orquesta la creación del pipeline.- Carga de documentos:
DirectoryLoadercarga los archivos de texto de nuestra base de conocimientos. - División en chunks:
RecursiveCharacterTextSplitterdivide los documentos en trozos más pequeños. Esto es esencial para que el modelo de embedding pueda procesar el texto de manera eficiente y para que la búsqueda por similitud sea precisa. - Vectorización e Indexación:
FAISS.from_documentses un paso clave. Toma los chunks de texto, utiliza el clienteOpenAIEmbeddingspara llamar a la API y obtener los vectores correspondientes, y luego almacena estos vectores en un índice FAISS en memoria. - Configuración del LLM: Utilizamos
ChatOpenAI, que es nativamente compatible con nuestra API para la parte de generación de respuestas. - Creación de la cadena
RetrievalQA: Esta es la cadena LangChain que conecta todos los elementos. Cuando se le hace una pregunta, esta: a. Utiliza elretriever(basado en nuestro índice FAISS) para encontrar los chunks de texto más relevantes. b. "Incrusta" (incorpora) estos chunks en un prompt junto con la pregunta. c. Envía este prompt enriquecido al LLM para generar una respuesta contextual.
- Carga de documentos:
- Ejecución: La función
mainsimula un uso real creando archivos de conocimiento temporales, construyendo el pipeline y haciendo una pregunta.
import os
import tempfile
import shutil
from pathlib import Path
from dotenv import load_dotenv

# --- Imports LangChain ---
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import FAISS
from langchain_classic.chains import RetrievalQA

# --- Configuration ---
# Charge les variables d'environnement (ex: LLMAAS_API_KEY)
load_dotenv()
API_KEY = os.getenv("LLMAAS_API_KEY")
BASE_URL = os.getenv("API_URL", "https://api.ai.cloud-temple.com/v1")
EMBEDDING_MODEL = "granite-embedding:278m"
LLM_MODEL = "gpt-oss:120b"

# --- Pipeline RAG ---
def setup_rag_pipeline(documents_path: str):
    """Configuration complète du pipeline RAG avec les outils LLMaaS."""
    print("1. Chargement et division des documents...")
    loader = DirectoryLoader(documents_path, glob="*.txt", loader_cls=TextLoader, loader_kwargs={'encoding': 'utf-8'})
    documents = loader.load()
    text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
    splits = text_splitter.split_documents(documents)
    print(f"   -> {len(documents)} document(s) chargé(s) et divisé(s) en {len(splits)} chunks.")

    print(f"2. Création des embeddings via LLMaaS (modèle: {EMBEDDING_MODEL})...")
    embeddings = OpenAIEmbeddings(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=EMBEDDING_MODEL,
        check_embedding_ctx_length=False,
        model_kwargs={"encoding_format": "float"},
    )

    print("3. Création de l'index vectoriel en mémoire (FAISS)...")
    vectorstore = FAISS.from_documents(splits, embeddings)
    print("   -> Index FAISS créé avec succès.")

    print(f"4. Configuration du LLM (modèle: {LLM_MODEL})...")
    llm = ChatOpenAI(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=LLM_MODEL,
        temperature=0.3,
        max_tokens=300
    )

    print("5. Création de la chaîne de Question/Réponse (RAG)...")
    qa_chain = RetrievalQA.from_chain_type(
        llm=llm,
        chain_type="stuff",
        retriever=vectorstore.as_retriever(),
        return_source_documents=True
    )
    print("   -> Pipeline RAG prêt.")
    return qa_chain

# --- Exécution ---
def main():
    """Fonction principale pour exécuter le pipeline RAG de bout en bout."""
    if not API_KEY:
        print("Erreur: La variable d'environnement LLMAAS_API_KEY n'est pas définie.")
        return

    # Créer des documents de test temporaires
    temp_dir = tempfile.mkdtemp()
    print(f"\nCréation de documents de test dans: {temp_dir}")
    try:
        documents_content = {
            "overview.txt": "Cloud Temple est un fournisseur de cloud souverain français qualifié SecNumCloud.",
            "pricing.txt": "Consultez le catalogue tarifaire officiel : https://www.cloud-temple.com/nos-tarifs-publics/"
        }
        for filename, content in documents_content.items():
            with open(Path(temp_dir) / filename, 'w', encoding='utf-8') as f:
                f.write(content)

        # Configurer et exécuter le pipeline
        rag_chain = setup_rag_pipeline(temp_dir)

        print("\n--- Interrogation du Pipeline RAG ---")
        question = "Quel est le tarif des tokens en sortie sur l'API LLMaaS de Cloud Temple ?"
        result = rag_chain.invoke({"query": question})

        print(f"\nQuestion: {question}")
        print(f"Réponse: {result['result']}")
        print("\nSources utilisées pour la réponse:")
        for source in result["source_documents"]:
            print(f"- Fichier: {os.path.basename(source.metadata['source'])}")
            print(f"  Contenu: \"{source.page_content}\"")

    finally:
        # Nettoyer le répertoire temporaire
        print(f"\nNettoyage du répertoire temporaire: {temp_dir}")
        shutil.rmtree(temp_dir)

if __name__ == "__main__":
    main()
3. Integración con una base de datos vectorial (Qdrant)
Para aplicaciones RAG en producción, se recomienda el uso de una base de datos vectorial dedicada como Qdrant. A diferencia de FAISS, que funciona en memoria, Qdrant ofrece persistencia de datos, capacidades de búsqueda avanzadas y una mejor escalabilidad.
El código explicado
Este tutorial adapta el pipeline RAG anterior para utilizar Qdrant.
- Requisitos previos: El primer paso es iniciar una instancia de Qdrant. La forma más sencilla es utilizar Docker.
setup_qdrant_rag_pipeline:- Embeddings y Documentos: La creación de los embeddings y de los documentos permanece idéntica al ejemplo anterior.
- Conexión a Qdrant: En lugar de crear un índice FAISS, utilizamos
QdrantVectorStore.from_documents. Este método de LangChain gestiona varios pasos: a. Se conecta a su instancia de Qdrant a través de la URL proporcionada. b. Crea una nueva "colección" (el equivalente a una tabla en una base de datos SQL) si no existe. c. Llama al clienteOpenAIEmbeddingspara vectorizar los documentos. d. Inserta los documentos y sus vectores en la colección de Qdrant. force_recreate=True: Para este tutorial, utilizamos este parámetro para asegurar que la colección esté vacía en cada ejecución. En producción, lo establecería enFalsepara conservar sus datos.
- El resto del pipeline (configuración del LLM, creación de la cadena
RetrievalQA) es idéntico, lo que demuestra la flexibilidad de LangChain: basta con cambiar la fuente delretriever(el buscador de información) para pasar de FAISS a Qdrant.
Para este tutorial, necesitará una instancia de Qdrant. Puede iniciarla fácilmente con Docker:
# 1. Télécharger la dernière image de Qdrant
docker pull qdrant/qdrant

# 2. Démarrer le conteneur Qdrant
docker run -p 6333:6333 -p 6334:6334 qdrant/qdrant
El código a continuación muestra cómo adaptar el pipeline RAG para utilizar Qdrant como base de datos vectorial. Los documentos de demostración son cortos; para sus propios documentos, aplique una división previa como en el tutorial de FAISS.
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_classic.chains import RetrievalQA
from langchain_qdrant import QdrantVectorStore
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitter

# --- Configuration ---
load_dotenv()
API_KEY = os.getenv("LLMAAS_API_KEY")
BASE_URL = os.getenv("API_URL", "https://api.ai.cloud-temple.com/v1")
EMBEDDING_MODEL = "granite-embedding:278m"
LLM_MODEL = "gpt-oss:120b"
QDRANT_URL = os.getenv("QDRANT_URL", "http://localhost:6333")
QDRANT_COLLECTION_NAME = "tutorial_collection"

def setup_qdrant_rag_pipeline():
    """Configure et retourne un pipeline RAG utilisant Qdrant."""
    print("1. Initialisation du client d'embedding LLMaaS...")
    embeddings = OpenAIEmbeddings(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=EMBEDDING_MODEL,
        check_embedding_ctx_length=False,
        model_kwargs={"encoding_format": "float"},
    )

    print("2. Préparation des documents...")
    documents_content = [
        "Cloud Temple est un fournisseur de cloud souverain français avec la qualification SecNumCloud.",
        "Les tarifs publics Cloud Temple sont disponibles sur https://www.cloud-temple.com/nos-tarifs-publics/",
    ]
    documents = [Document(page_content=d) for d in documents_content]

    print(f"3. Connexion à Qdrant et peuplement de la collection '{QDRANT_COLLECTION_NAME}'...")
    vectorstore = QdrantVectorStore.from_documents(
        documents,
        embeddings,
        url=QDRANT_URL,
        collection_name=QDRANT_COLLECTION_NAME,
        force_recreate=True, # Assure une collection propre pour le tutoriel
    )
    print("   -> Collection créée et peuplée avec succès.")

    print(f"4. Configuration du LLM ({LLM_MODEL})...")
    llm = ChatOpenAI(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=LLM_MODEL,
        temperature=0.3
    )

    print("5. Création de la chaîne RAG...")
    qa_chain = RetrievalQA.from_chain_type(
        llm=llm,
        retriever=vectorstore.as_retriever(),
        return_source_documents=True
    )
    print("   -> Pipeline RAG avec Qdrant prêt.")
    return qa_chain

# --- Exécution ---
def main_qdrant():
    """Fonction principale pour exécuter le pipeline RAG avec Qdrant."""
    if not API_KEY:
        print("Erreur: La variable d'environnement LLMAAS_API_KEY n'est pas définie.")
        return

    try:
        rag_chain = setup_qdrant_rag_pipeline()
        question = "Quels sont les tarifs de l'API LLMaaS de Cloud Temple ?"

        print(f"\n--- Interrogation du pipeline ---")
        result = rag_chain.invoke({"query": question})

        print(f"\nQuestion: {question}")
        print(f"Réponse: {result['result']}")
        print("\nSources utilisées pour la réponse:")
        for source in result["source_documents"]:
            print(f"- Contenu: \"{source.page_content}\"")

    except Exception as e:
        print(f"\nUne erreur est survenue: {e}")
        print("Veuillez vous assurer que le conteneur Qdrant est bien en cours d'exécution.")

if __name__ == "__main__":
    main_qdrant()
4. Agentes LangChain con Herramientas
Un agente es un LLM que no solo responde a una pregunta, sino que puede utilizar un conjunto de herramientas (funciones, APIs, etc.) para construir una respuesta más compleja. Puede razonar, descomponer un problema, elegir una herramienta, ejecutarla, observar el resultado y repetir este ciclo hasta obtener una respuesta final.
El código explicado
Este ejemplo construye un agente simple capaz de utilizar dos herramientas: una para consultar una API (simulada) de Cloud Temple y otra para realizar cálculos.
- Definición de las Herramientas: Las clases
CloudTempleAPIToolySimpleCalculatorToolheredan deBaseTool. Cada herramienta tiene:- Un
name(nombre): un nombre simple y descriptivo. - Una
description(descripción): crucial, es lo que lee el LLM para decidir qué herramienta utilizar. Debe ser muy clara sobre lo que hace la herramienta y cuándo usarla. - Un método
_run: el código que se ejecuta realmente cuando el agente elige esta herramienta.
- Un
create_agent_with_tools:- Inicialización del LLM: Utilizamos nuestro wrapper
CloudTempleLLMdefinido en el primer tutorial. - Lista de herramientas: Proporcionamos al agente la lista de herramientas que tiene derecho a utilizar.
- Prompt del agente: El prompt es muy específico. Se trata de un "prompt de razonamiento" que instruye al LLM sobre cómo pensar (
Thought), elegir una acción (Action), proporcionar una entrada a esa acción (Action Input) y observar el resultado (Observation). Este es el mecanismo central del framework ReAct (Reasoning and Acting) utilizado aquí. - Creación del agente:
create_react_agentensambla el LLM, las herramientas y el prompt para crear el agente. AgentExecutor: Es el motor que ejecuta al agente en bucle hasta que produce unaFinal Answer(Respuesta Final). El parámetroverbose=Truees muy útil para ver el "diálogo interno" del agente (sus pensamientos, acciones, etc.).
- Inicialización del LLM: Utilizamos nuestro wrapper
from langchain_classic.agents import AgentExecutor, create_react_agent
from langchain_core.tools import BaseTool
from langchain_core.prompts import PromptTemplate
import requests
import json
import os

# (La classe CloudTempleLLM est la même que dans le premier exemple)

# --- Définition des Outils ---

class CloudTempleAPITool(BaseTool):
    """Un outil qui simule un appel à une API interne pour obtenir des informations sur les services."""
    name: str = "cloud_temple_api_checker"
    description: str = "Utile pour obtenir des informations sur les services, produits et offres de Cloud Temple."

    def _run(self, query: str) -> str:
        # Dans un cas réel, ceci appellerait une véritable API.
        print(f"--- Outil CloudTempleAPITool appelé avec la requête: '{query}' ---")
        if "service" in query.lower():
            return "Cloud Temple propose les services suivants : IaaS, PaaS, LLMaaS, Sécurité Managée."
        return "Information non trouvée."

    async def _arun(self, query: str) -> str:
        # Implémentation asynchrone non nécessaire pour cet exemple.
        raise NotImplementedError("L'outil API ne supporte pas l'exécution asynchrone.")

class SimpleCalculatorTool(BaseTool):
    """Un outil simple pour effectuer des calculs mathématiques."""
    name: str = "simple_calculator"
    description: str = (
        "Effectue une opération entre deux nombres, séparés par des espaces : "
        "par exemple '125 * 8'. Opérateurs autorisés : +, -, *, /. "
        "Pour un calcul composé, appeler l'outil plusieurs fois."
    )

    def _run(self, expression: str) -> str:
        import math
        import operator

        operations = {
            "+": operator.add,
            "-": operator.sub,
            "*": operator.mul,
            "/": operator.truediv,
        }
        try:
            if len(expression) > 100:
                raise ValueError("Entrée trop longue.")
            left, symbol, right = expression.split()
            if symbol not in operations:
                raise ValueError("Opérateur autorisé : +, -, * ou /.")
            left, right = float(left), float(right)
            if not (math.isfinite(left) and math.isfinite(right)):
                raise ValueError("Les nombres doivent être finis.")
            result = operations[symbol](left, right)
            if not math.isfinite(result):
                raise ValueError("Résultat hors limites.")
            return str(result)
        except (ValueError, OverflowError, ZeroDivisionError) as e:
            return f"Erreur de calcul: {e}"

    async def _arun(self, expression: str) -> str:
        raise NotImplementedError("L'outil Calculatrice ne supporte pas l'exécution asynchrone.")

# --- Création de l'Agent ---

def create_agent():
    """Configure et retourne un agent LangChain avec les outils définis."""
    print("1. Initialisation du LLM pour l'agent...")
    llm = CloudTempleLLM(api_key=os.getenv("LLMAAS_API_KEY", "votre-clé-api-ici"))

    tools = [CloudTempleAPITool(), SimpleCalculatorTool()]

    # Le template de prompt est crucial : il guide le LLM dans son raisonnement.
    template = """
    Réponds aux questions suivantes du mieux que tu peux. Tu as accès aux outils suivants :

    {tools}

    Utilise le format suivant :

    Question: la question à laquelle tu dois répondre
    Thought: tu dois toujours réfléchir à ce que tu vas faire
    Action: l'action à prendre, doit être l'un de [{tool_names}]
    Action Input: l'entrée de l'action
    Observation: le résultat de l'action
    ... (cette séquence Thought/Action/Action Input/Observation peut se répéter)
    Thought: Je connais maintenant la réponse finale.
    Final Answer: la réponse finale à la question d'origine

    Commence !

    Question: {input}
    Thought:{agent_scratchpad}
    """

    prompt = PromptTemplate.from_template(template)

    print("2. Création de l'agent avec le framework ReAct...")
    agent = create_react_agent(llm, tools, prompt)

    # L'AgentExecutor est responsable de l'exécution des cycles de l'agent.
    agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True)
    print("   -> Agent prêt.")
    return agent_executor

# --- Exécution ---

def run_agent():
    """Exécute l'agent avec différentes questions pour tester ses capacités."""
    if os.getenv("LLMAAS_API_KEY") is None:
        print("Veuillez configurer votre LLMAAS_API_KEY.")
        return

    agent_executor = create_agent()

    print("\n--- Test 1 : Question nécessitant un outil d'information ---")
    question1 = "Quels sont les services offerts par Cloud Temple ?"
    response1 = agent_executor.invoke({"input": question1})
    print(f"\nRéponse finale de l'agent: {response1['output']}")

    print("\n--- Test 2 : Question nécessitant un calcul ---")
    question2 = "Quel est le résultat de 125 * 8 + 50 ?"
    response2 = agent_executor.invoke({"input": question2})
    print(f"\nRéponse finale de l'agent: {response2['output']}")

if __name__ == "__main__":
    run_agent()
5. Integración del SDK de OpenAI
Configuración del SDK OpenAI para LLMaaS
Este ejemplo utiliza las llamadas compatibles con LLMaaS. Para adaptar una aplicación existente, consulta las diferencias documentadas.
from openai import OpenAI

# Configuration pour Cloud Temple LLMaaS
def setup_cloud_temple_client():
    """Configuration client OpenAI pour Cloud Temple"""

    client = OpenAI(
        api_key="your-cloud-temple-api-key",
        base_url="https://api.ai.cloud-temple.com/v1"
    )

    return client

def test_openai_compatibility():
    """Test de compatibilité avec SDK OpenAI"""

    client = setup_cloud_temple_client()

    # Chat completion standard
    response = client.chat.completions.create(
        model="gpt-oss:120b",
        messages=[
            {"role": "system", "content": "Tu es un assistant IA professionnel."},
            {"role": "user", "content": "Explique-moi l'architecture cloud native."}
        ],
        max_tokens=300,
        temperature=0.7
    )

    print(f"Réponse: {response.choices[0].message.content}")

    # Streaming
    stream = client.chat.completions.create(
        model="gpt-oss:120b",
        messages=[
            {"role": "user", "content": "Écris un poème sur l'IA."}
        ],
        stream=True,
        max_tokens=200
    )

    print("Stream:")
    for chunk in stream:
        if chunk.choices[0].delta.content is not None:
            print(chunk.choices[0].delta.content, end="")
    print()

# Test de compatibilité
test_openai_compatibility()
5. Integración de Semantic Kernel (Microsoft)
Semantic Kernel es un SDK de código abierto de Microsoft que permite integrar LLMs en aplicaciones .NET, Python y Java. Aunque está optimizado para los servicios Azure OpenAI, su flexibilidad permite utilizarlo con cualquier API compatible con OpenAI, incluida la nuestra.
El código explicado
Este ejemplo no requiere el SDK completo de Semantic Kernel. Demuestra cómo el concepto de "función semántica" puede implementarse mediante una simple llamada a nuestra API. Una función semántica es esencialmente un prompt estructurado enviado a un LLM para realizar una tarea específica.
semantic_kernel_simple(): Esta función simula una "función de resumen".- Prompt Estructurado: Utilizamos un mensaje
systempara dar un rol al LLM ("Eres un experto en resumen.") y un mensajeuserque contiene el texto a resumir. Este es el núcleo del concepto de función semántica. - Llamada API Directa: Una simple llamada
requests.posta nuestro endpoint/v1/chat/completionses suficiente para ejecutar la función.
Este ejemplo ilustra que no siempre es necesario utilizar un framework pesado. Para tareas simples y bien definidas, una llamada directa a la API LLMaaS suele ser la solución más eficiente y performante.
import requests
import os
from dotenv import load_dotenv

def semantic_kernel_simulation():
    """
    Simule une "fonction sémantique" de résumé en appelant directement l'API LLMaaS.
    """
    load_dotenv()
    api_key = os.getenv("LLMAAS_API_KEY")
    if not api_key:
        print("Veuillez définir la variable d'environnement LLMAAS_API_KEY.")
        return

    headers = {
        "Authorization": f"Bearer {api_key}",
        "Content-Type": "application/json"
    }

    text_to_summarize = """
    L'intelligence artificielle (IA) transforme de nombreux secteurs industriels en automatisant les tâches,
    en optimisant les processus et en permettant des analyses prédictives avancées.
    Cloud Temple, avec son offre LLMaaS souveraine et certifiée SecNumCloud, permet aux entreprises
    d'intégrer ces capacités d'IA tout en garantissant la sécurité et la confidentialité de leurs données.
    """

    # Le prompt combine une instruction (rôle système) et des données (rôle utilisateur)
    payload = {
        "model": "gpt-oss:120b",
        "messages": [
            {"role": "system", "content": "Tu es un assistant expert en synthèse de documents techniques."},
            {"role": "user", "content": f"Résume le texte suivant en une seule phrase concise: {text_to_summarize}"}
        ],
        "max_tokens": 100,
        "temperature": 0.5
    }

    try:
        response = requests.post(
            "https://api.ai.cloud-temple.com/v1/chat/completions",
            headers=headers,
            json=payload,
            timeout=30
        )
        response.raise_for_status()
        result = response.json()
        summary = result['choices'][0]['message']['content']

        print("Texte original:\n", text_to_summarize)
        print("\nRésumé généré:\n", summary)
        return summary

    except requests.exceptions.RequestException as e:
        print(f"Une erreur d'API est survenue: {e}")

if __name__ == "__main__":
    semantic_kernel_simulation()
6. Framework Haystack
Haystack es otro framework potente de código abierto para construir aplicaciones de búsqueda semántica, RAG y agentes. Al igual que con Semantic Kernel, nuestra API puede integrarse directamente.
El código explicado
Este ejemplo simula un "pipeline" básico de Haystack para la búsqueda de respuestas en un contexto dado (Question Answering).
process_with_context: Esta función representa el núcleo de un pipeline de QA. Toma uncontexto(por ejemplo, un párrafo de un documento) y unapregunta.- Prompt Contextual : El prompt está cuidadosamente estructurado para incluir tanto el contexto como la pregunta. Es una técnica fundamental en RAG: se proporcionan al LLM la información relevante para que pueda formular una respuesta factual.
- Llamada a la API : Una vez más, una simple llamada
requests.posta nuestra API es suficiente. El LLM recibe el contexto y la pregunta, y su tarea es sintetizar una respuesta basada únicamente en la información proporcionada.
Este ejemplo ilustra la flexibilidad de la API LLMaaS, que puede servir como bloque de construcción básico para la generación de texto en cualquier framework, incluso aquellos para los cuales no existe una integración oficial.
import requests
import os
from dotenv import load_dotenv

def haystack_simulation():
    """
    Simule un pipeline de Question-Answering de type Haystack
    en utilisant un appel direct à l'API LLMaaS.
    """
    load_dotenv()
    api_key = os.getenv("LLMAAS_API_KEY")
    if not api_key:
        print("Veuillez définir la variable d'environnement LLMAAS_API_KEY.")
        return

    headers = {
        "Authorization": f"Bearer {api_key}",
        "Content-Type": "application/json"
    }

    # Le contexte est l'information que le LLM est autorisé à utiliser.
    context = """
    Un cloud souverain est une infrastructure de cloud computing qui est entièrement contenue
    dans les frontières d'un pays spécifique et soumise à ses lois.
    Les principaux avantages sont la garantie de la résidence des données, la conformité avec
    les réglementations locales (comme le RGPD en Europe), et une protection accrue contre
    l'accès par des entités étrangères en vertu de lois extraterritoriales comme le CLOUD Act américain.
    """

    question = "Quels sont les avantages d'un cloud souverain ?"

    # Le prompt guide le LLM pour qu'il base sa réponse sur le contexte fourni.
    prompt = f"""
    En te basant uniquement sur le contexte suivant, réponds à la question.

    Contexte:
    ---
    {context}
    ---

    Question: {question}
    """

    payload = {
        "model": "gpt-oss:120b",
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 200,
        "temperature": 0.2 # Température basse pour une réponse factuelle
    }

    try:
        response = requests.post(
            "https://api.ai.cloud-temple.com/v1/chat/completions",
            headers=headers,
            json=payload,
            timeout=30
        )
        response.raise_for_status()
        result = response.json()
        answer = result['choices'][0]['message']['content']

        print(f"Question: {question}")
        print("\nRéponse générée:\n", answer)
        return answer

    except requests.exceptions.RequestException as e:
        print(f"Une erreur d'API est survenue: {e}")

if __name__ == "__main__":
    haystack_simulation()
7. Integración con LlamaIndex
LlamaIndex es un framework especializado en la construcción de aplicaciones RAG. Ofrece componentes de alto nivel para la ingestión de datos, indexación e interrogación. Nuestra API, al ser compatible con la interfaz de OpenAI, se integra muy fácilmente.
El código explicado
Este ejemplo muestra cómo configurar LlamaIndex para utilizar la API LLMaaS para la generación de texto, mientras se utiliza un modelo de embedding local para la vectorización.
setup_and_run_llamaindex: Esta única función orquesta todo el proceso.- Configuración del LLM : LlamaIndex proporciona una clase
OpenAILikeque permite conectarse a cualquier API que respete el formato de OpenAI. Solo hay que proporcionarle nuestroapi_basey unaapi_key. Este es el método más simple para hacer nuestro LLM compatible. - Configuración de Embeddings : Para este ejemplo, utilizamos un modelo de embedding local (
HuggingFaceEmbedding). Esto muestra la flexibilidad de LlamaIndex, que permite mezclar componentes. Settings: El objetoSettingsde LlamaIndex es una forma práctica de configurar los componentes por defecto (LLM, modelo de embedding, tamaño de los chunks, etc.) que serán utilizados por los demás objetos de LlamaIndex.- Ingestión de datos :
SimpleDirectoryReadercarga los documentos de una carpeta. - Creación del índice :
VectorStoreIndex.from_documentses el método de alto nivel de LlamaIndex. Gestiona automáticamente el fragmentado en chunks, la vectorización de los chunks (utilizando elembed_modelconfigurado enSettings), y la creación del índice en memoria. - Motor de consultas :
.as_query_engine()crea una interfaz simple para hacer preguntas a nuestro índice. Cuando se llama a.query(), el motor vectoriza tu pregunta, encuentra los documentos más relevantes en el índice, y los envía al LLM (configurado enSettings) junto con la pregunta para generar una respuesta.
- Configuración del LLM : LlamaIndex proporciona una clase
# Dépendances:
# pip install llama-index llama-index-llms-openai-like llama-index-embeddings-huggingface

import os
from dotenv import load_dotenv
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader, Settings
from llama_index.llms.openai_like import OpenAILike
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from tempfile import TemporaryDirectory

def setup_and_run_llamaindex():
    """
    Configure et exécute un pipeline RAG simple avec LlamaIndex et l'API LLMaaS.
    """
    load_dotenv()
    api_key = os.getenv("LLMAAS_API_KEY")
    if not api_key:
        print("Veuillez définir la variable d'environnement LLMAAS_API_KEY.")
        return

    # 1. Configuration du LLM pour utiliser l'API LLMaaS via l'interface OpenAILike
    print("1. Configuration du LLM pour pointer vers l'API LLMaaS...")
    llm = OpenAILike(
        api_key=api_key,
        api_base="https://api.ai.cloud-temple.com/v1",
        model="gpt-oss:120b",
        is_chat_model=True,
        # Il est parfois nécessaire d'ajouter des paramètres de contexte pour certains modèles
        # context_window=3900,
    )

    # 2. Configuration du modèle d'embedding (local dans cet exemple pour la simplicité)
    print("2. Configuration du modèle d'embedding local...")
    embed_model = HuggingFaceEmbedding(
        model_name="sentence-transformers/all-MiniLM-L6-v2"
    )

    # 3. Application des configurations globales via l'objet Settings de LlamaIndex
    Settings.llm = llm
    Settings.embed_model = embed_model
    print("   -> LLM et modèle d'embedding configurés.")

    # 4. Création d'une base de connaissances simple dans un répertoire temporaire
    print("4. Création et chargement d'une base de connaissances temporaire...")
    with TemporaryDirectory(prefix="llmaas_llamaindex_") as temp_dir:
        knowledge_file = os.path.join(temp_dir, "knowledge.txt")
        with open(knowledge_file, "w", encoding="utf-8") as f:
            f.write("L'offre LLMaaS de Cloud Temple est une solution d'IA générative souveraine, "
                    "entièrement opérée en France et qualifiée SecNumCloud par l'ANSSI.")

        documents = SimpleDirectoryReader(temp_dir).load_data()
        print(f"   -> {len(documents)} document(s) chargé(s).")
    # Les documents sont en mémoire ; le dossier temporaire est supprimé,
    # y compris si l'écriture ou le chargement échoue.

    # 5. Création de l'index vectoriel. LlamaIndex gère le chunking et l'embedding.
    print("5. Création de l'index vectoriel...")
    index = VectorStoreIndex.from_documents(documents)
    print("   -> Index créé.")

    # 6. Création du moteur de requête et interrogation de la base de connaissances
    print("6. Création du moteur de requête et interrogation...")
    query_engine = index.as_query_engine()
    question = "Quelles sont les garanties de souveraineté de l'offre LLMaaS ?"
    response = query_engine.query(question)

    print(f"\nQuestion: {question}")
    print(f"Réponse: {response}")


if __name__ == "__main__":
    setup_and_run_llamaindex()
8. Configuración de la extensión CLINE para VSCode
Este tutorial le guía para configurar la extensión CLINE en Visual Studio Code con el fin de utilizar los modelos de lenguaje de Cloud Temple directamente desde su editor.
Pasos de configuración
-
Abrir los ajustes de CLINE : En VSCode, abra los ajustes de la extensión CLINE.
-
Crear un nuevo modelo : Añada una nueva configuración de modelo.
-
Rellenar los campos : Configure los campos como se indica a continuación, basándose en la imagen de abajo.
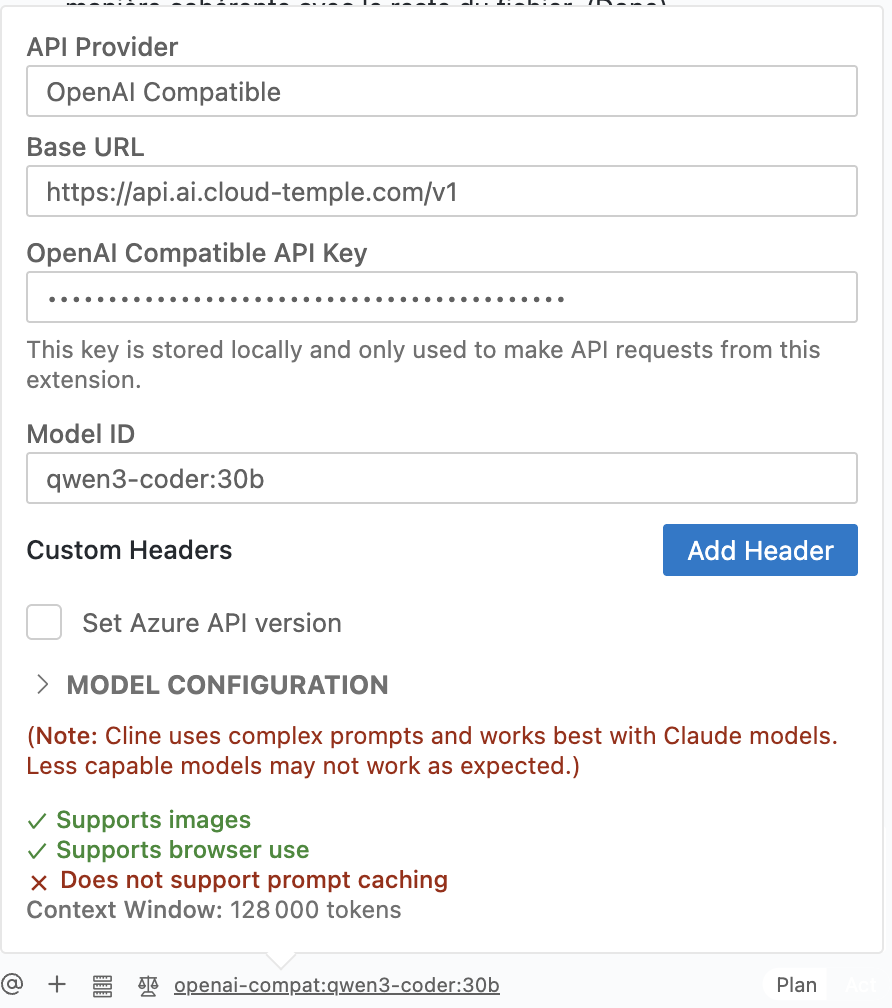
- API Provider: Seleccione
OpenAI Compatible. - Base URL: Introduzca el endpoint de la API LLMaaS de Cloud Temple:
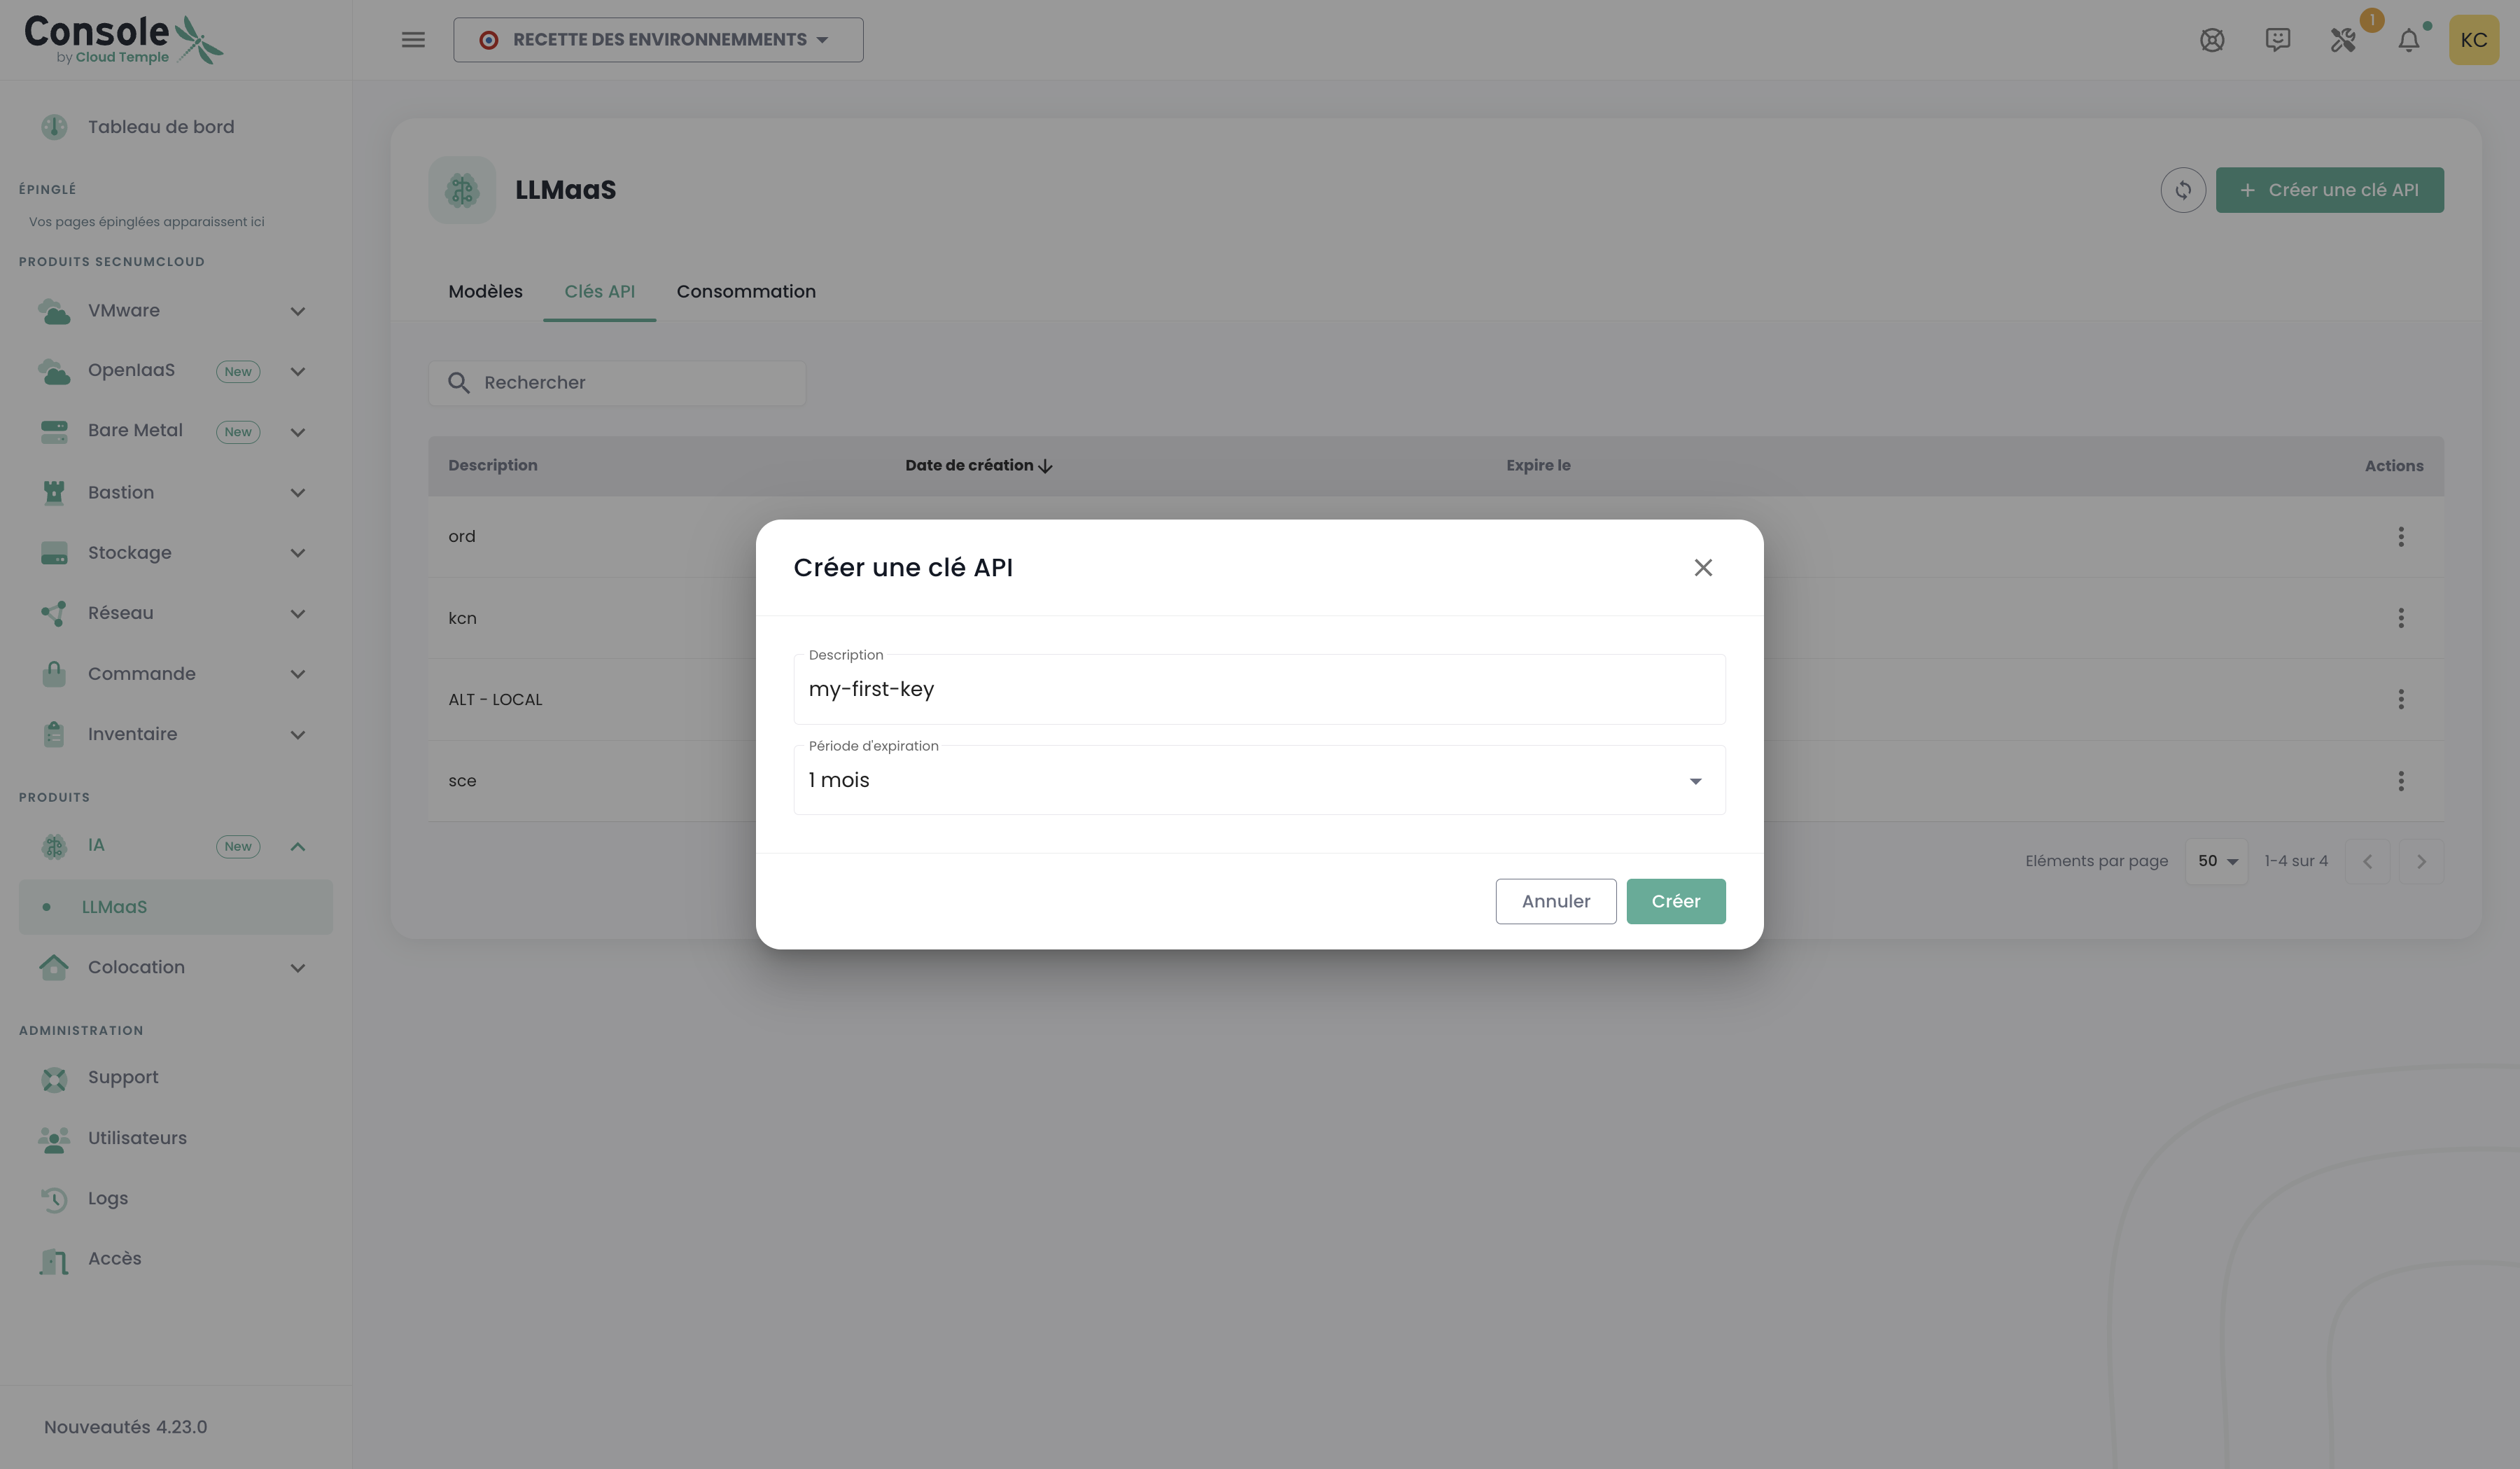
https://api.ai.cloud-temple.com/v1. - OpenAI Compatible API Key: Pegue la clave de API que ha generado desde la consola de Cloud Temple.
Generación de la clave APIPara generar su clave API, vaya a la consola de Cloud Temple, sección LLMaaS > Claves API, y haga clic en "Crear una clave API".
- Model ID: Especifique el modelo que desea utilizar, por ejemplo
qwen3.6:35b. Puede encontrar la lista de modelos disponibles en la sección Modelos. - Model Configuration:
- Supports Images: Marque esta casilla si el modelo soporta imágenes.
- Supports browser use: Marque esta casilla.
- Context Window Size: Indique el tamaño de la ventana de contexto del modelo (ej:
128000). - Max Output Tokens: Déjelo en
-1para una salida ilimitada por defecto. - Temperature: Ajuste la temperatura según sus necesidades (ej:
0).
- API Provider: Seleccione
Ahora puede seleccionar un modelo en CLINE y utilizarlo para generar código, responder preguntas, etc.
💡 Ejemplos Avanzados
Encontrarás en el siguiente repositorio de GitHub una colección de ejemplos de código y scripts que demuestran las distintas funcionalidades y casos de uso de la oferta LLM as a Service (LLMaaS) de Cloud Temple:
Cloud-Temple/product-llmaas-how-to
Allí encontrarás guías prácticas para:
-
Extracción de Información y Análisis de Texto: Capacidad de analizar documentos para extraer datos estructurados como entidades, eventos, relaciones y atributos, basándose en ontologías específicas de dominios (ej: legal, RRHH, TI).
-
Interacción Conversacional y Chatbots: Desarrollo de agentes conversacionales capaces de dialogar, mantener un historial de intercambio, utilizar instrucciones del sistema (prompts del sistema) e invocar herramientas externas.
-
Transcripción de Audio (Speech-to-Text): Conversión de contenido de audio a texto, incluyendo archivos grandes, gracias a técnicas de segmentación, normalización y procesamiento por lotes.
-
Traducción de Texto: Traducción de documentos de un idioma a otro, gestionando el contexto en múltiples segmentos para mejorar la coherencia.
-
Gestión y Evaluación de Modelos: Listado de los modelos de lenguaje disponibles a través de la API, consulta de sus especificaciones y ejecución de pruebas para comparar su rendimiento.
-
Streaming de Respuestas en Tiempo Real: Demostración de la capacidad de recibir y mostrar las respuestas de los modelos de manera progresiva (token por token), esencial para aplicaciones interactivas.
-
Pipeline RAG con Base de Conocimientos en Memoria: Demostrador RAG educativo para ilustrar el funcionamiento de la Generación Aumentada por Recuperación (RAG). Utiliza la API LLMaaS para la incrustación (embedding) y la generación, con almacenamiento de vectores en memoria (FAISS) para una comprensión clara del proceso.
-
Pipeline RAG con Base de Datos Vectorial (Qdrant): Demostrador RAG completo y contenedorizado que utiliza Qdrant como base de datos vectorial. La API LLMaaS se utiliza para la incrustación (embedding) de documentos y la generación de respuestas aumentadas.
-
OCR y Análisis de Documentos (DeepSeek-OCR): Guía completa y herramienta de demostración para convertir imágenes y PDFs en Markdown estructurado, extraer tablas y transcribir fórmulas matemáticas. Consulta la documentación dedicada.