Guía: Dominar el OCR con DeepSeek
Esta guía detalla el uso del modelo DeepSeek-OCR, una solución de vanguardia para la compresión óptica de contexto y el análisis de documentos.
Esta guía describe la integración de DeepSeek-OCR. Antes de utilizarlo, verifica que el modelo esté expuesto por GET /v1/models y consulta el catálogo y ciclo de vida. Si no está disponible, selecciona un modelo de visión adecuado y utiliza el formato de solicitud correspondiente; los parámetros específicos de esta guía no son universales.
Arquitectura y funcionamiento
A diferencia de los OCR tradicionales, DeepSeek-OCR es un modelo Visión-Lenguaje de extremo a extremo diseñado para "leer" y "comprender" visualmente los documentos.
Arquitectura técnica
Combina dos componentes innovadores:
- DeepEncoder (380M) : Un codificador visual híbrido que combina SAM-base (para percepción local) y CLIP-large (para conocimiento global), conectados por un compresor convolutivo 16x. Esto permite procesar imágenes de alta resolución con muy pocos tokens visuales.
- Decodificador MoE (3B) : Basado en DeepSeek3B-MoE (570M parámetros activos), genera texto estructurado a partir de los tokens visuales comprimidos.
Modos de resolución y consumo
El modelo adapta su consumo de tokens a la resolución de la imagen. Cuanto mayor sea la imagen, más tokens consumirá, pero mejor será la precisión.
| Modo | Resolución (px) | Tokens de Visión | Uso Recomendado |
|---|---|---|---|
| Tiny | 512 x 512 | 64 | Diapositivas, texto muy grande |
| Small | 640 x 640 | 100 | Documentos simples, tickets |
| Base | 1024 x 1024 | 256 | Páginas A4 estándar |
| Large | 1280 x 1280 | 400 | Documentos densos, caracteres pequeños |
| Gundam | Dinámico | ~800 | Periódicos, planos, escaneos complejos |
Para optimizar tus costos y la latencia, redimensiona tus imágenes a la resolución mínima necesaria para que el texto siga siendo legible.
Soporte multilingüe
El modelo fue entrenado en un vasto corpus de documentos multilingües y soporta el reconocimiento de casi 100 idiomas (incluyendo francés, inglés, chino, árabe, etc.), con o sin preservación del formato.
Guía de prompts (Ingeniería de prompts)
La calidad del resultado depende directamente del prompt utilizado. DeepSeek-OCR responde a instrucciones específicas para activar sus diferentes capacidades.
1. OCR estándar (Markdown)
Para extraer el texto con su estructura (títulos, párrafos, tablas).
Prompt :
Convert the document to markdown.
Resultado : Texto estructurado, tablas formateadas, formato preservado.
2. "Deep parsing" (Figuras, gráficos, fórmulas)
Para analizar el contenido semántico de gráficos, fórmulas químicas o geométricas.
Prompt :
Parse the figure.
Capacidades :
- Gráficos (Bar/Line/Pie) : Convierte a tabla HTML o Markdown.
- Fórmulas Químicas : Convierte a formato SMILES.
- Geometría : Describe los elementos geométricos.
3. Grounding (localización)
Para encontrar las coordenadas de un elemento específico en la imagen.
Prompt :
Locate <|ref|>elemento a encontrar<|/ref|> in the image.
Ejemplo : Locate <|ref|>Total<|/ref|> in the image.
Resultado : Devuelve las coordenadas de la caja delimitadora (bounding box) del elemento.
4. Detección de objetos
Para listar y localizar todos los objetos visibles.
Prompt :
Identify all objects in the image and output them in bounding boxes.
Tutorial de implementación (Python)
Aquí tienes un ejemplo completo que muestra cómo estructurar tu llamada a la API para utilizar estas capacidades.
Requisitos previos: formato de la imagen y dependencias
- Formato : JPEG o PNG.
- Modo : RGB (sin transparencia Alpha).
- PDF : Deben convertirse a imágenes previamente (150-300 DPI).
- Tamaño : Se recomienda redimensionar las imágenes de muy alta resolución para evitar errores de límite de tamaño (413 Payload Too Large).
Instala las librerías necesarias:
pip install requests Pillow
Código: análisis de documento (OCR)
Tomemos el ejemplo de este ticket de caja suizo:
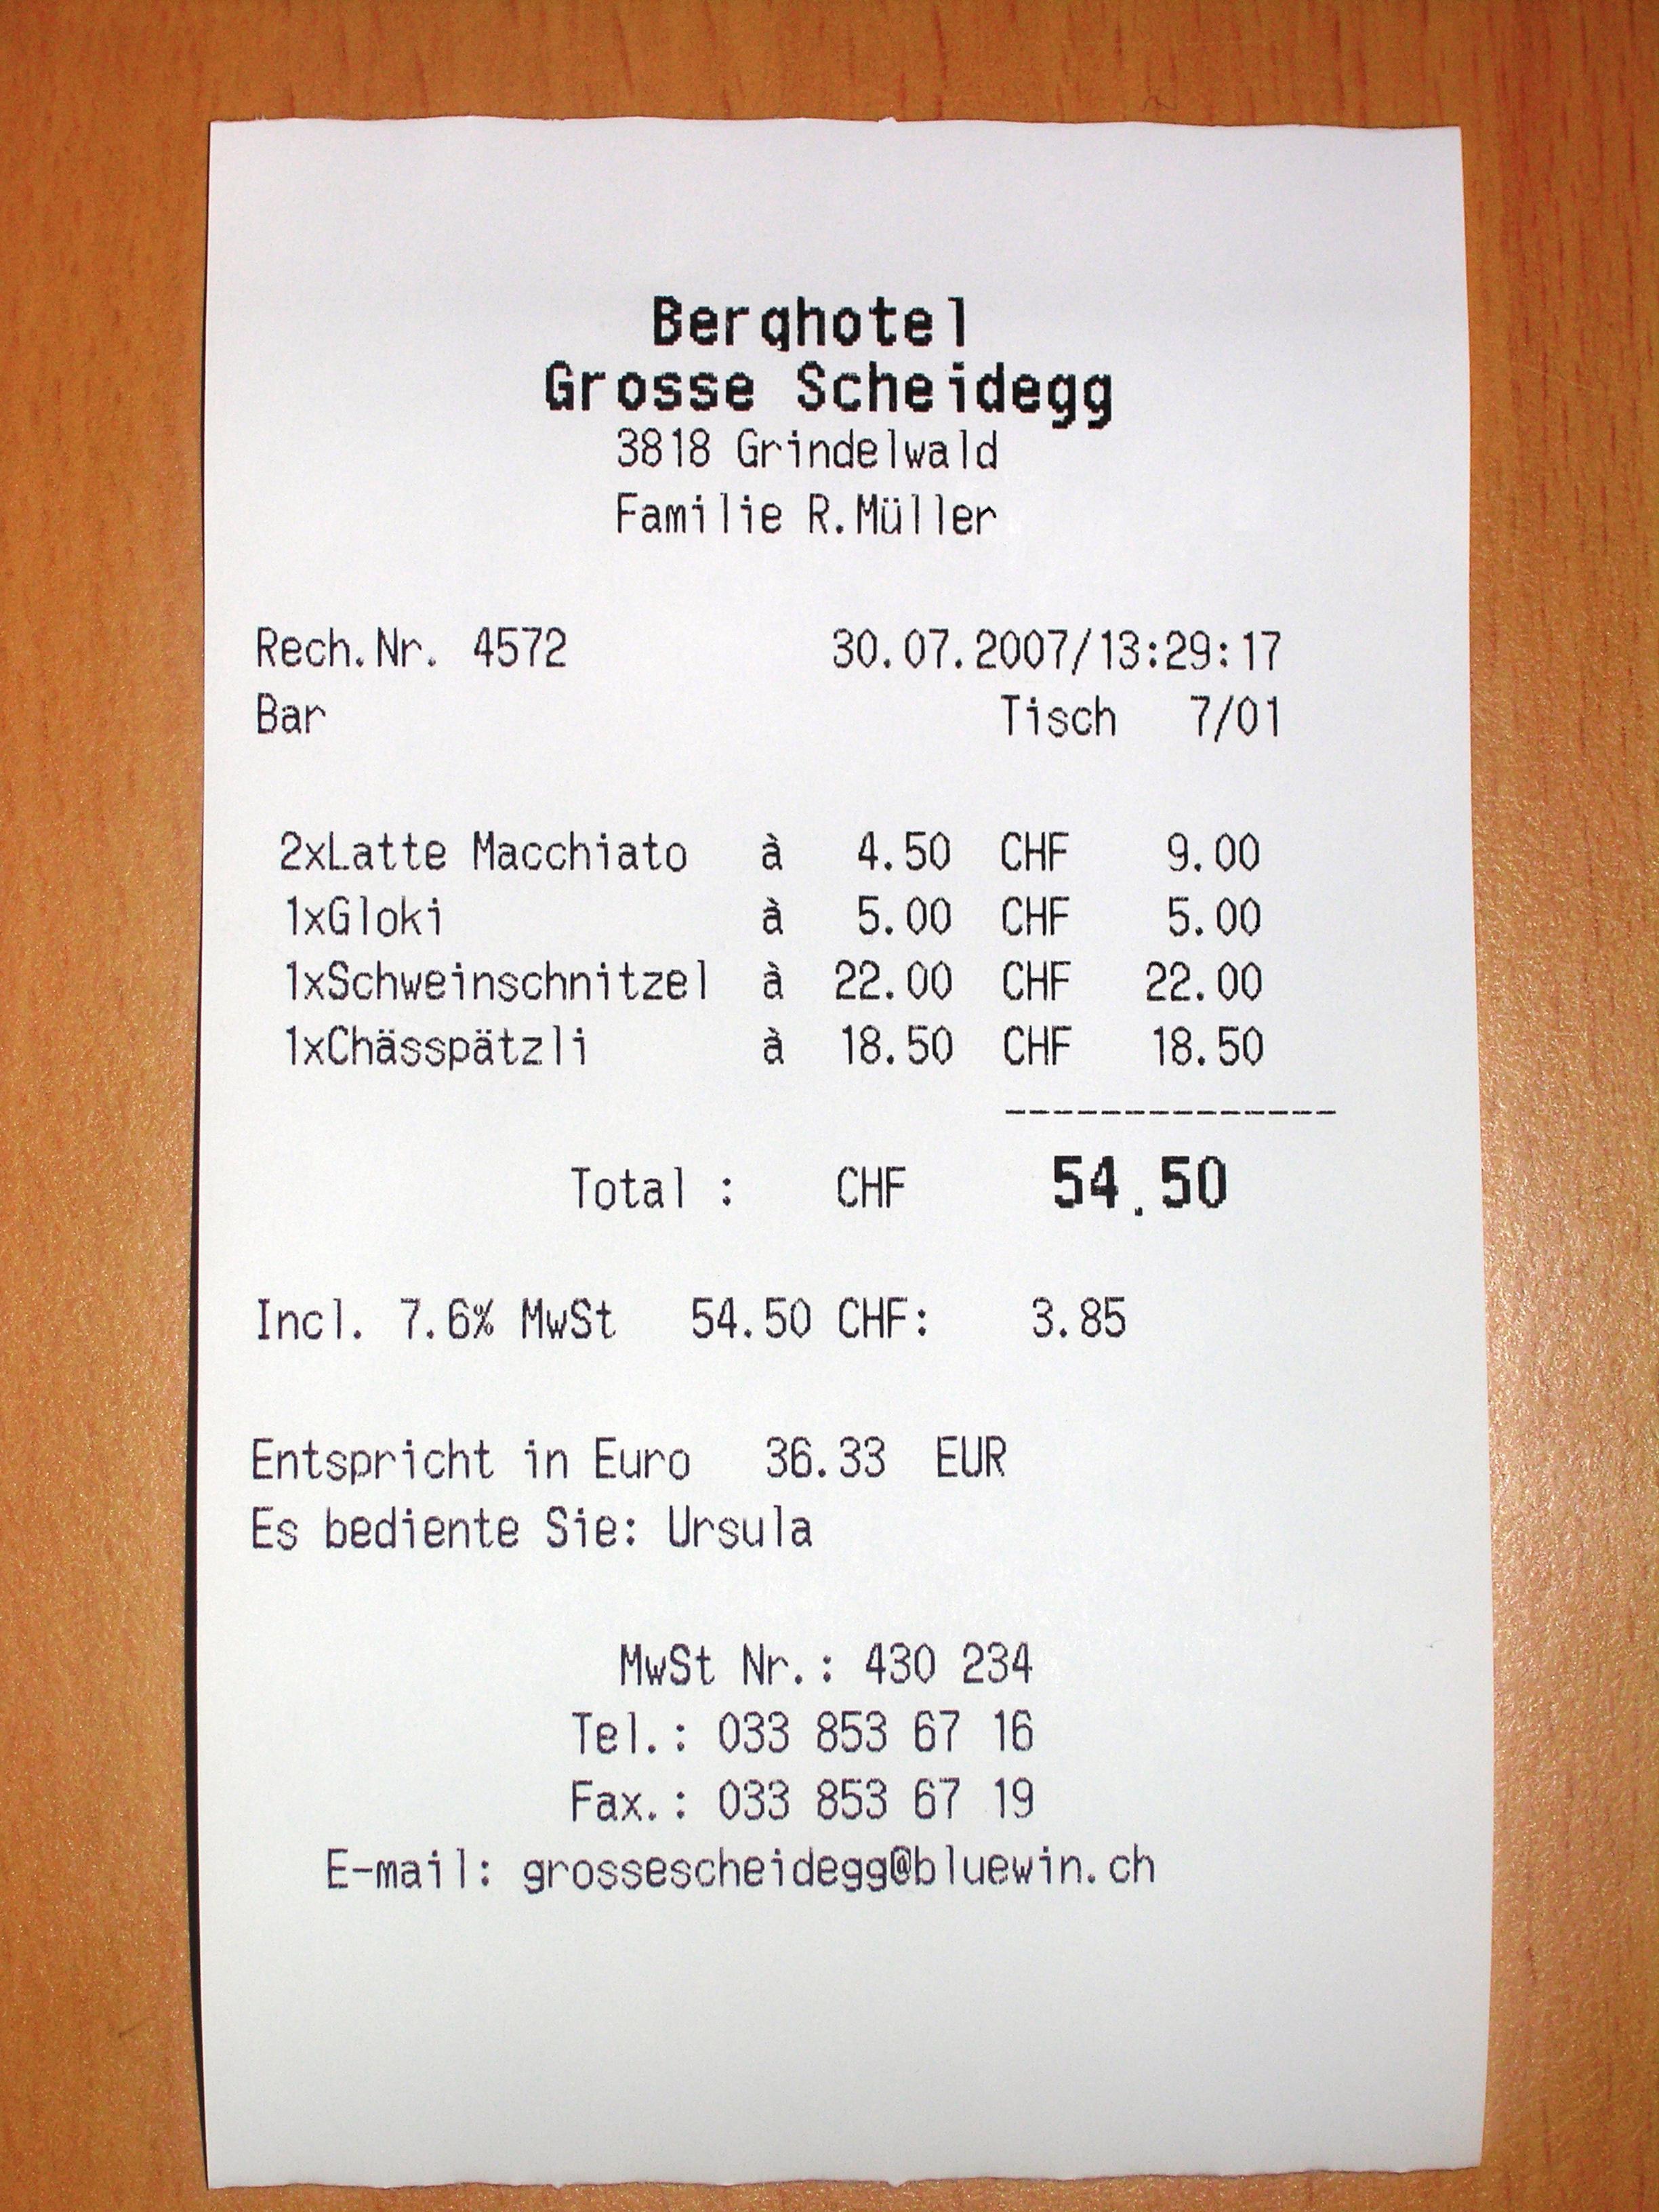
Aquí tienes un script robusto que maneja el redimensionamiento y la codificación óptima de la imagen:
import base64
import io
import requests
from PIL import Image

# Configuration
API_KEY = "VOTRE_TOKEN_API"
API_URL = "https://api.ai.cloud-temple.com/v1/chat/completions"
IMAGE_PATH = "ReceiptSwiss.jpg" # Assurez-vous que l'image est dans le dossier courant

def encode_image_optimized(path):
    """
    Optimise l'image (redimensionnement + compression JPEG) pour l'API.
    """
    with Image.open(path) as img:
        # 1. Conversion RGB (pour éviter problèmes PNG/Alpha)
        if img.mode != 'RGB':
            img = img.convert('RGB')

        # 2. Redimensionnement intelligent si trop grand (> 2048px)
        # Cela évite l'erreur 413 (Payload Too Large) et accélère le traitement
        max_size = 2048
        if max(img.size) > max_size:
            img.thumbnail((max_size, max_size))

        # 3. Compression JPEG en mémoire
        buffer = io.BytesIO()
        img.save(buffer, format="JPEG", quality=85)

        return base64.b64encode(buffer.getvalue()).decode('utf-8')

# 1. Construction du message multimodal
encoded_image = encode_image_optimized(IMAGE_PATH)

payload = {
    "model": "deepseek-ai/DeepSeek-OCR",
    "messages": [
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": "Convert the document to markdown." # Prompt OCR Standard
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/jpeg;base64,{encoded_image}"
                    }
                }
            ]
        }
    ],
    "temperature": 0.0, # CRUCIAL : 0.0 pour la fidélité
    "max_tokens": 4096
}

# 2. Envoi
print("Envoi de la requête...")
response = requests.post(
    API_URL,
    headers={"Authorization": f"Bearer {API_KEY}"},
    json=payload
)

# 3. Résultat
if response.status_code == 200:
    print("\n--- Résultat OCR ---\n")
    print(response.json()['choices'][0]['message']['content'])
else:
    print(f"Erreur {response.status_code}: {response.text}")
Ejemplo de salida :
# Berghotel
**Grosse Scheidegg**
3818 Grindelwald
Familie R. Müller

Rech. Nr.  4572
Bar    Tisch   7/01

2xLatte Macchiato    à   4.50 CHF   9.00
1xGloki    à   5.00 CHF   5.00
...

**Total :** CHF **54.50**
**Incl. 7.6% MwSt** 54.50 CHF: 3.85
Código: análisis de gráfico (deep parsing)
Para analizar un gráfico financiero en un informe, simplemente cambia el texto del prompt en el payload anterior:
# ... dans le payload ...
"text": "Parse the figure."
# ...
El modelo devolverá una representación textual o tabular de los datos del gráfico.
Casos de uso avanzados
Extracción de tablas complejas
DeepSeek-OCR destaca en la conversión de tablas, incluso sin líneas de delimitación claras.
Imagen de entrada — inventario técnico ficticio :

Estos datos ilustran la extracción de una tabla; no definen plantillas comerciales de Cloud Temple.
Salida Markdown esperada :
| Équipement | Quantité | vCPU | RAM (Gio) |
|---|---|---|---|
| Serveur web | 2 | 4 | 16 |
| Serveur de calcul | 1 | 8 | 32 |
| Serveur de test | 3 | 2 | 8 |
Para los precios públicos del servicio, consulta el catálogo de tarifas oficial de Cloud Temple.
Fórmulas matemáticas (LaTeX)
Ideal para documentos académicos. El modelo reconoce las ecuaciones y las exporta en sintaxis LaTeX estándar.
Imagen de Entrada :
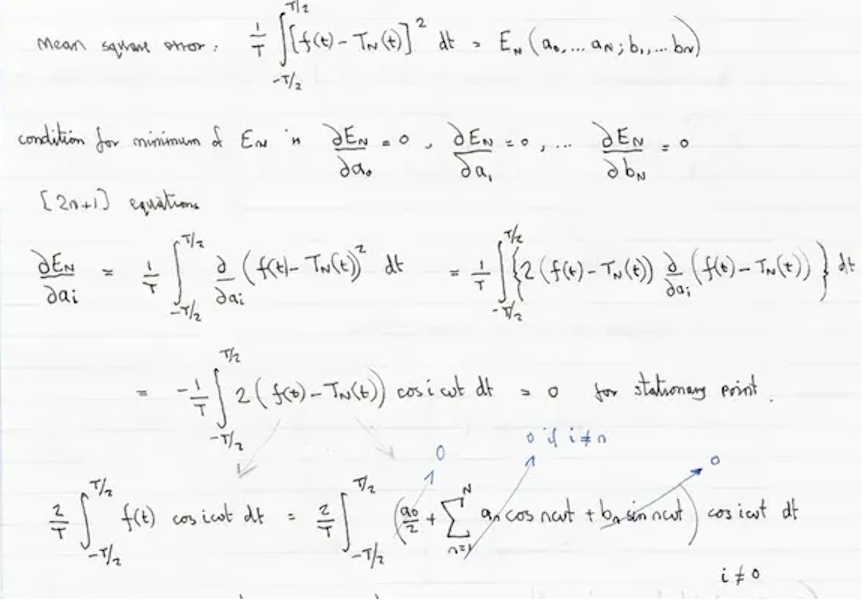
Salida del Modelo (Prompt: "Convert to latex.") :
Aquí tienes la representación matemática del resultado del OCR :
Error cuadrático medio:
Condición para el mínimo de en:
(2n+1) ecuaciones:
Limitaciones conocidas
- Orientación : El modelo no maneja la rotación automática. Asegúrate de que tus imágenes estén bien orientadas (texto horizontal).
- Texto manuscrito : Aunque es eficiente, la tasa de error es más alta en la escritura manuscrita cursiva compleja que en el texto impreso.
- Muy alta resolución : Las imágenes que superan las dimensiones del modo "Gundam" (~2000x2000) se redimensionan, lo que puede hacer ilegible el texto microscópico. Divide los planos muy grandes en varias imágenes.