Conceptos y Arquitectura LLMaaS
Vista General
El servicio LLMaaS (Large Language Models as a Service) de Cloud Temple proporciona acceso seguro y soberano a los modelos de inteligencia artificial más avanzados, con la calificación SecNumCloud de la ANSSI.
🏗️ Arquitectura Técnica
Infraestructura Cloud Temple
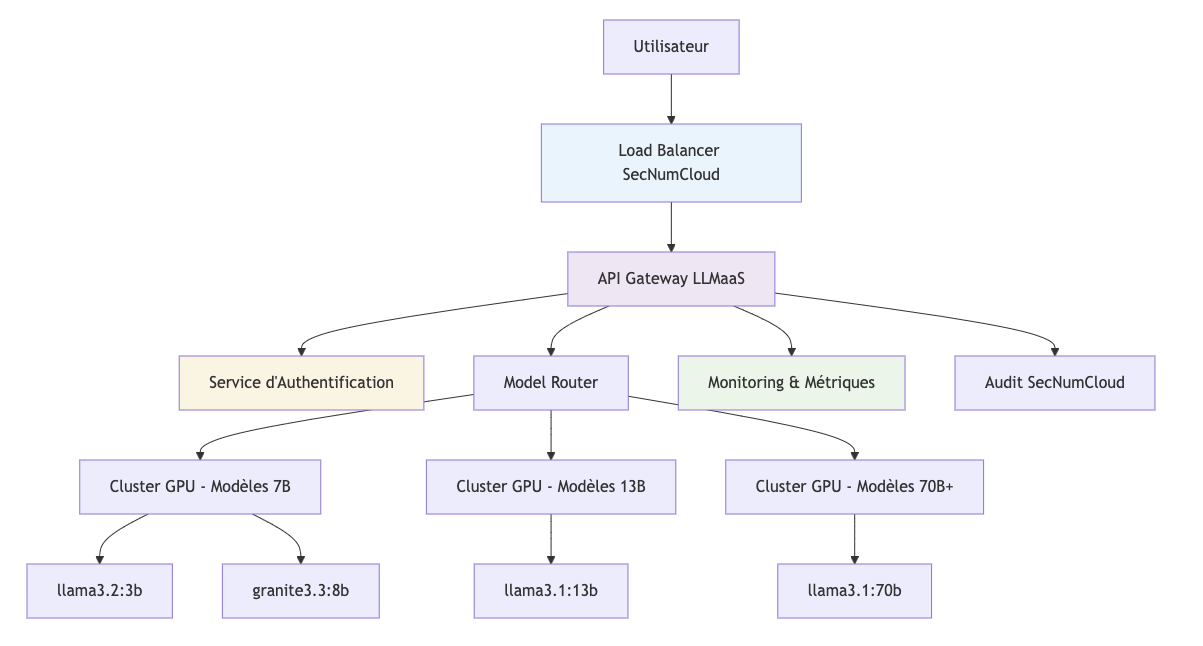
Componentes Principales
1. API Gateway LLMaaS
- Compatible con OpenAI : Integración transparente con el ecosistema existente
- Rate Limiting : Gestión de cuotas por nivel de facturación
- Load Balancing : Distribución de las solicitudes sobre los recursos de inferencia
- Monitoring : Métricas en tiempo real y alertas
2. Servicio de Autenticación
- Claves API : Creación, rotación y revocación bajo la responsabilidad del cliente. Consulte el compartir de responsabilidades (RACI).
- Control de acceso : Permisos granulares por modelo
- Audit trails : Trazabilidad completa de los accesos
🤖 Modelos y Tokens
Catálogo de Modelos
Consulte el catálogo y ciclo de vida y la guía de elección.
Gestión de Tokens
Tipos de Tokens
- Tokens de entrada : Su prompt y contexto
- Tokens de salida : Respuesta generada por el modelo
- Tokens del sistema : Metadatos e instrucciones
Cálculo de Costes
Para conocer los precios públicos vigentes y elaborar su estimación, consulte el catálogo tarifario oficial de Cloud Temple.
El coste depende de los volúmenes consumidos (tokens, documentos o duración de audio) y de las unidades de facturación aplicables.
Optimización
- Context window : Reutilice las conversaciones para ahorrar
- Modelos adecuados : Elija el tamaño según la complejidad
- Max tokens : Limite la longitud de las respuestas
Tokenización
# Exemple d'estimation de tokens
def estimate_tokens(text: str) -> int:
    """Estimation approximative : 1 token ≈ 4 caractères"""
    return len(text) // 4

prompt = "Expliquez la photosynthèse"
response_max = 200  # tokens max souhaités

estimated_input = estimate_tokens(prompt)  # ~6 tokens
print(f"Tokens estimés : {estimated_input}; limite de sortie : {response_max}")
🔒 Seguridad y Cumplimiento
Calificación SecNumCloud
El servicio LLMaaS se ejecuta en una infraestructura técnica que cuenta con la calificación SecNumCloud 3.2 de la ANSSI, garantizando:
Protección de Datos
- Cifrado de extremo a extremo : TLS 1.3 para todos los intercambios
- Almacenamiento seguro : Datos cifrados en reposo (AES-256)
Soberanía Digital
- Alojamiento en Francia : Centros de datos Cloud Temple certificados
- Derecho francés : Cumplimiento nativo del RGPD
- Sin exposición : Ninguna transferencia hacia nubes extranjeras
Auditoría y Trazabilidad
- Registros completos : Todas las interacciones trazadas
- Retención : Conservación según políticas legales
- Cumplimiento : Informes de auditoría disponibles
Controles de Seguridad

Seguridad de los Prompts
La plataforma LLMaaS no aplica un filtrado automático del contenido de los prompts contra inyecciones o intentos de elusión de instrucciones (jailbreaks).
Los controles de contenido deben implementarse en su aplicación según su caso de uso. Puede llamar explícitamente a un modelo de seguridad del catálogo para evaluar las entradas o las respuestas. Estos modelos no se ejecutan automáticamente sobre las solicitudes dirigidas a otros modelos.
Defina los criterios de filtrado y el tratamiento de los resultados con sus equipos de negocio, y pruébelos en sus datos, especialmente para medir los falsos positivos. El compartir de responsabilidades especifica los roles del cliente y de Cloud Temple.
📈 Rendimiento y Escalabilidad
Monitorización en Tiempo Real
Acceso a través de la Consola Cloud Temple :
- Métricas de uso por modelo
- Gráficos de latencia y rendimiento
- Alertas sobre umbrales de rendimiento
- Historial de solicitudes
🌐 Integración y Ecosistema
Compatibilidad con OpenAI
El servicio LLMaaS es compatible con la API de OpenAI :
# Migration transparente
from openai import OpenAI

# Avant (OpenAI)
client_openai = OpenAI(api_key="sk-...")

# Après (Cloud Temple LLMaaS)
client_ct = OpenAI(
    api_key="votre-token-cloud-temple",
    base_url="https://api.ai.cloud-temple.com/v1"
)

# Code identique !
response = client_ct.chat.completions.create(
    model="gpt-oss:120b",  # Modèle Cloud Temple
    messages=[{"role": "user", "content": "Bonjour"}]
)
Ecosistema Soportado
Frameworks de IA
- ✅ LangChain : Integración nativa
- ✅ Haystack : Pipeline de documentos
- ✅ Semantic Kernel : Orquestación de Microsoft
- ✅ AutoGen : Agentes conversacionales
Herramientas de Desarrollo
- ✅ Jupyter : Cuadernos interactivos
- ✅ Streamlit : Aplicaciones web rápidas
- ✅ Gradio : Interfaces de usuario de IA
- ✅ FastAPI : APIs backend
Plataformas No-Code
- ✅ Zapier : Automatizaciones
- ✅ Make : Integraciones visuales
- ✅ Bubble : Aplicaciones web
🔄 Ciclo de Vida de los Modelos
El ciclo de vida de los modelos publica los estados, plazos y migraciones recomendadas. Consúltelo antes de elegir un modelo y durante la explotación de su aplicación.
Leer el ciclo de vida
- DMP : fecha de puesta en producción.
- DSP : fecha de salida de producción (fin del soporte) anunciada para el modelo.
- LTS (Long Term Support) : modelo que beneficia de un soporte extendido; verifique la fecha publicada para el modelo en cuestión.
- Producción : modelo indicado en producción en el catálogo.
- Deprecated : modelo obsoleto para el cual debe prepararse una migración. Este estado no significa necesariamente que las llamadas API ya estén interrumpidas.
- Planned : modelo anunciado, cuya disponibilidad debe verificarse antes de su uso.
Los anuncios de adición, redirección y retirada se publican en el changelog del servicio. Para una necesidad de estabilidad o soporte particular, contacte con el soporte para precisar las modalidades aplicables.
Redirecciones y antiguos identificadores
Algunos antiguos identificadores se redirigen hacia un modelo sucesor. Una solicitud puede por tanto seguir funcionando mientras es tratada por otro modelo. La continuidad de la llamada API no garantiza respuestas idénticas, ni las mismas capacidades, latencias o límites de contexto.
Migración hacia otro modelo
- Identifique el modelo concernido, el plazo y el sucesor recomendado en el ciclo de vida.
- Verifique el identificador del sucesor con
GET /v1/modelsy sus capacidades : visión, llamadas a herramientas, razonamiento y contexto según su uso. - Pruebe el sucesor en una muestra representativa de sus solicitudes : calidad, formatos de salida, herramientas, latencia y consumo.
- Actualice el parámetro
modelen la configuración de su aplicación tras la validación, y luego supervise los resultados. - Para los embeddings, prevé recalcular los vectores y reconstruir el índice si el modelo cambia.
Modelos obsoletos
La lista y los destinos de migración están disponibles en el catálogo de ciclo de vida. Si no se indica ninguna migración, contacte con el soporte antes del plazo para elegir una solución adecuada.
💡 Buenas Prácticas
Para sacar el máximo partido de la API LLMaaS, es esencial adoptar estrategias de optimización de costes, rendimiento y seguridad.
Optimización de Costes
El control de los costes se basa en un uso inteligente de los tokens y los modelos.
-
Elección del Modelo : Compare varios modelos en ejemplos representativos de su uso. Quedese con el que responda a sus requisitos de calidad y latencia, y luego mida su consumo de tokens. Consulte el catálogo de ciclo de vida para identificar los modelos disponibles y sus sucesores. La facturación depende de la tarifa aplicable y de los volúmenes consumidos; el tamaño del modelo por sí solo no determina el coste facturado.
-
Gestión del Contexto : El historial de la conversación (
messages) se devuelve en cada llamada, consumiendo tokens de entrada. Para conversaciones largas, considere estrategias de resumen o de ventana para conservar solo la información relevante.# Para una conversación larga, se pueden resumir los primeros intercambios.messages = [{"role": "system", "content": "Vous êtes un assistant IA."},{"role": "user", "content": "Résumé des 10 premiers échanges..."},{"role": "assistant", "content": "Ok, j'ai le contexte."},{"role": "user", "content": "Voici ma nouvelle question."}] -
Limitación de Tokens de Salida : Utilice siempre el parámetro
max_tokenspara evitar respuestas excesivamente largas y costosas. Fije un límite razonable en función de lo que espera.# Pedir un resumen de máximo 100 palabras.response = client.chat.completions.create(model="gpt-oss:120b",messages=[{"role": "user", "content": "Résume ce document..."}],max_tokens=150, # Margen de seguridad para ~100 palabras)
Rendimiento
La reactividad de su aplicación depende de la manera en que gestione las llamadas a la API.
-
Síncronas Asíncronas : Para procesar varias solicitudes sin esperar a que finalice cada una, utilice llamadas asíncronas. Esto es especialmente útil para aplicaciones backend que procesan un gran volumen de solicitudes simultáneas.
import asynciofrom openai import AsyncOpenAIclient = AsyncOpenAI(api_key="...", base_url="...")async def process_prompt(prompt: str):# Procesa una sola solicitud de manera asíncronaresponse = await client.chat.completions.create(model="gpt-oss:120b", messages=[{"role": "user", "content": prompt}])return response.choices[0].message.contentasync def batch_requests(prompts: list):# Lanza varias tareas en paralelo y espera su finalizacióntasks = [process_prompt(p) for p in prompts]return await asyncio.gather(*tasks) -
Streaming para la Experiencia de Usuario (UX) : Para las interfaces de usuario (chatbots, asistentes), el streaming es esencial. Permite mostrar la respuesta del modelo palabra por palabra, dando una impresión de reactividad inmediata en lugar de esperar a la respuesta completa.
# Muestra la respuesta en tiempo real en una interfaz de usuarioresponse_stream = client.chat.completions.create(model="gpt-oss:120b",messages=[{"role": "user", "content": "Raconte-moi une histoire."}],stream=True)for chunk in response_stream:if chunk.choices[0].delta.content:# Mostrar el fragmento de texto en la UIprint(chunk.choices[0].delta.content, end="", flush=True)
Seguridad
La seguridad de tu aplicación es primordial, especialmente cuando se procesan entradas del usuario.
-
Validación y Limpieza de Entradas (Sanitization): Nunca confíes en las entradas del usuario. Antes de enviarlas a la API, límpialas para eliminar cualquier código potencialmente malicioso o instrucciones de "inyección de prompt". También limita su tamaño para evitar abusos.
def sanitize_input(user_input: str) -> str:# Ejemplo simple: eliminar delimitadores de código y limitar la longitud.# Se pueden utilizar bibliotecas más robustas para una sanitización avanzada.cleaned = user_input.replace("`", "").replace("'", "").replace("\"", "")return cleaned[:2000] # Limita el tamaño a 2000 caracteres -
Gestión Robusta de Errores: Envuelve siempre tus llamadas a la API en bloques
try...exceptpara gestionar errores de red, errores de la API (por ejemplo, 429 Límite de tasa, 500 Error interno del servidor) y proporcionar una experiencia de usuario degradada pero funcional.from openai import APIError, APITimeoutErrortry:response = client.chat.completions.create(...)except APITimeoutError:# Gestionar el caso en que la solicitud tarda demasiadoreturn "El servicio tarda más de lo previsto, por favor inténtelo de nuevo."except APIError as e:# Gestionar errores específicos de la APIlogger.error(f"Error API LLMaaS: {e.status_code} - {e.message}")return "Lo sentimos, ha ocurrido un error con el servicio de IA."except Exception as e:# Gestionar todos los demás errores (red, etc.)logger.error(f"Ha ocurrido un error inesperado: {e}")return "Lo sentimos, ha ocurrido un error inesperado."