LLMaaS-Anleitungen
Die verwendeten Identifikatoren veranschaulichen die Integrationen. Prüfen Sie deren Verfügbarkeit mit GET /v1/models, ihre Fähigkeiten und ihren Lebenszyklus. Passen Sie die Konfiguration an Ihren Verwendungszweck an; ein alter Name kann auf einen Nachfolger umgeleitet werden.
Überblick
Diese Anleitungen zeigen Beispiele zur Integration mit LLMaaS. Der Umfang der Überprüfung der LangChain-Beispiele wird unten angegeben; die Ergebnisse und Demonstrationsdaten stellen keine Leistungsmaße des Dienstes dar.
🚀 LangChain-Integrationen und Frameworks
LangChain-Voraussetzungen
Die LangChain-Beispiele 1 bis 4 sowie die aus der API-Referenz wurden am 7. September 2026 mit Python 3.13.15 und den folgenden Versionen überprüft. Installieren Sie diese in einer dedizierten Umgebung:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install \
  langchain-classic==1.0.8 langchain-core==1.6.2 langchain-openai==1.6.0 \
  langchain-community==0.4.2 langchain-text-splitters==1.1.2 \
  langchain-qdrant==1.1.0 qdrant-client==1.19.0 faiss-cpu==1.15.0 \
  pydantic==2.13.5 python-dotenv==1.2.3 requests==2.34.2 httpx==0.28.1
Diese Versionen definieren eine Referenzumgebung; bewerten Sie die Beispiele vor einem Update der Abhängigkeiten erneut.
Die historischen Ketten LLMChain, RetrievalQA und der ReAct-Agent dieser Anleitungen verwenden langchain-classic, entsprechend dem LangChain-Migrationsleitfaden. Diese Wahl bewahrt die Struktur der bestehenden Beispiele; einige Klassen geben Deprecation-Warnungen aus. Für ein neues Projekt konsultieren Sie die aktuellen, von LangChain empfohlenen Schnittstellen.
Durchgeführte Prüfungen: Laden der Beispiele, Aufruf des Wrappers, Suche und Generierung mit FAISS und Qdrant im Speicher, Ausführen eines Tools durch den Agenten, Chat und Embeddings der API-Referenz. Die LLMaaS-HTTP-Antworten wurden simuliert und Netzwerkzugriffe blockiert. Diese Prüfungen validieren weder die Modelle in der Produktion noch die Verbindung zu einem entfernten Qdrant-Server.
1. Basisintegration mit LangChain
Dieses erste Beispiel zeigt, wie unsere LLMaaS-API mit dem beliebten Framework LangChain integriert wird, indem ein benutzerdefinierter „Wrapper“ erstellt wird. Ein Wrapper ist eine Klasse, die unsere API „umhüllt“, um sie mit den internen Mechanismen von LangChain kompatibel zu machen.
Der Code erklärt
Der folgende Code definiert eine Klasse CloudTempleLLM, die von der Basisklasse LLM von LangChain erbt. Dies ermöglicht es uns, ein maßgeschneidertes Verhalten zu definieren, während wir mit dem LangChain-Ökosystem (Ketten, Agenten usw.) kompatibel bleiben.
CloudTempleLLM(LLM): Unsere Klasse erbt vonLLM, was uns zwingt, bestimmte Methoden zu implementieren, insbesondere_call._call(self, prompt: str, ...): Dies ist das Herzstück unseres Wrappers. Jedes Mal, wenn LangChain unseren Sprachmodell aufrufen muss, wird diese Methode aufgerufen. Innerhalb formatieren wir eine Standard-HTTP-POST-Anfrage mit den richtigen Headern (Authorization) und dempayload, das unsere API/v1/chat/completionserwartet.exemple_langchain_wrapper(): Diese Demonstrationsfunktion zeigt, wie unser Wrapper verwendet wird. Wir instanziieren ihn, erstellen einPromptTemplate, um unsere Anfrage zu strukturieren, und kombinieren sie in einerLLMChain. Wenn wir die Kette ausführen (chain.invoke(...)), ruft LangChain im Hintergrund die von uns definierte Methode_callauf.
Dieser Ansatz ist nützlich, wenn Sie die volle Kontrolle darüber wünschen, wie LangChain mit der API interagiert, ist jedoch ausführlicher als die Verwendung des Clients ChatOpenAI (siehe API-Referenz).
# Installation des dépendances
# Voir les versions validées dans les prérequis LangChain ci-dessus.

from langchain_core.language_models.llms import LLM
from typing import Optional, List, Any
from pydantic import Field
import requests
import json
import os

# --- Configuration ---
# Il est recommandé de stocker votre clé API dans une variable d'environnement
API_KEY = os.getenv("LLMAAS_API_KEY", "votre-clé-api-ici")
BASE_URL = "https://api.ai.cloud-temple.com/v1"

class CloudTempleLLM(LLM):
    """
    Wrapper LangChain personnalisé pour l'API LLMaaS de Cloud Temple.
    Cette classe permet d'utiliser notre API comme un LLM standard dans LangChain.
    """

    api_key: str = Field(default="")
    model_name: str = Field(default="gpt-oss:120b")
    temperature: float = Field(default=0.7)
    max_tokens: int = Field(default=1000)

    @property
    def _llm_type(self) -> str:
        """Identifiant unique pour notre type de LLM."""
        return "cloud_temple_llmaas"

    def _call(self, prompt: str, stop: Optional[List[str]] = None) -> str:
        """
        La méthode principale qui effectue l'appel à l'API LLMaaS.
        LangChain utilise cette méthode pour chaque requête au modèle.
        """
        headers = {
            "Authorization": f"Bearer {self.api_key}",
            "Content-Type": "application/json"
        }

        payload = {
            "model": self.model_name,
            "messages": [{"role": "user", "content": prompt}],
            "temperature": self.temperature,
            "max_tokens": self.max_tokens
        }

        if stop:
            payload["stop"] = stop

        # Exécution de la requête POST vers l'API
        response = requests.post(
            f"{BASE_URL}/chat/completions",
            headers=headers,
            json=payload,
            timeout=60
        )

        response.raise_for_status()  # Lève une exception en cas d'erreur HTTP
        result = response.json()

        # Retourne le contenu du message de l'assistant
        return result['choices'][0]['message']['content']

# --- Exemple d'utilisation ---
from langchain_classic.chains import LLMChain
from langchain_core.prompts import PromptTemplate

def exemple_langchain_wrapper():
    """Démontre l'utilisation du wrapper LLM avec une chaîne LangChain."""

    # 1. Initialisation de notre LLM personnalisé
    llm = CloudTempleLLM(
        api_key=API_KEY,
        model_name="gpt-oss:120b"
    )

    # 2. Création d'un template de prompt pour structurer les requêtes
    template = """
    Tu es un expert en {domaine}.
    Réponds à cette question de manière détaillée et professionnelle :

    Question: {question}

    Réponse:
    """
    prompt = PromptTemplate(
        input_variables=["domaine", "question"],
        template=template
    )

    # 3. Création d'une chaîne qui combine le prompt et le LLM
    chain = LLMChain(llm=llm, prompt=prompt)

    # 4. Exécution de la chaîne avec des variables spécifiques
    result = chain.invoke({
        "domaine": "cybersécurité",
        "question": "Quelles sont les meilleures pratiques pour sécuriser une API REST ?"
    })

    return result["text"]

# --- Lancement du test ---
if __name__ == "__main__":
    if API_KEY == "votre-clé-api-ici":
        print("Veuillez configurer votre LLMAAS_API_KEY dans vos variables d'environnement.")
    else:
        reponse = exemple_langchain_wrapper()
        print("Réponse de l'expert en cybersécurité :\n")
        print(reponse)
2. RAG (Retrieval-Augmented Generation) mit der LLMaaS-API
RAG ist eine leistungsstarke Technik, die es einem LLM ermöglicht, Fragen zu beantworten, indem es sich auf eine externe Wissensbasis stützt. Diese Anleitung führt Sie durch die Erstellung eines einfachen RAG-Pipelines unter Verwendung unserer API für Embeddings und Generierung sowie FAISS, einer Bibliothek für Vektorsimilität, um einen Index im Speicher zu erstellen.
Der Code erklärt
Die Pipeline gliedert sich in mehrere logische Schritte:
- Konfiguration: Wir importieren die erforderlichen Bibliotheken und laden unseren API-Schlüssel aus den Umgebungsvariablen. Wir definieren die zu verwendenden Modelle:
granite-embedding:278mfür die Vektorisierung undgpt-oss:120bfür die Generierung. OpenAIEmbeddings: Der Standard-Client sendet Texte an LLMaaS mitcheck_embedding_ctx_length=Falseund fordert numerische Vektoren mitencoding_format="float"an. Das Aufteilen der Dokumente erfolgt vor dem Aufruf; siehe Embedding-Einstellungen.setup_rag_pipeline: Diese Funktion orchestriert die Erstellung der Pipeline.- Dokumentenladung:
DirectoryLoaderlädt die Textdateien aus unserem Wissensspeicher. - Aufteilung in Chunks:
RecursiveCharacterTextSplitterteilt die Dokumente in kleinere Stücke auf. Dies ist entscheidend, damit das Embedding-Modell den Text effizient verarbeiten kann und die Ähnlichkeitssuche präzise ist. - Vektorisierung und Indexierung:
FAISS.from_documentsist ein Schlüsselschritt. Er nimmt die Text-Chunks, verwendet denOpenAIEmbeddings-Client, um die API aufzurufen und die entsprechenden Vektoren zu erhalten, und speichert diese Vektoren dann in einem FAISS-Index im Speicher. - LLM-Konfiguration: Wir verwenden
ChatOpenAI, das nativ mit unserer API für den Antwortteil kompatibel ist. - Erstellung der
RetrievalQA-Kette: Dies ist die LangChain-Kette, die alle Elemente verbindet. Wenn man ihr eine Frage stellt, tut sie Folgendes: a. Verwendet denretriever(basierend auf unserem FAISS-Index), um die relevantesten Text-Chunks zu finden. b. "Füllt" (Stuff) diese Chunks in einen Prompt zusammen mit der Frage. c. Sendet diesen angereicherten Prompt an das LLM, um eine kontextbezogene Antwort zu generieren.
- Dokumentenladung:
- Ausführung: Die Funktion
mainsimuliert eine echte Nutzung, indem sie temporäre Wissensdateien erstellt, die Pipeline aufbaut und eine Frage stellt.
import os
import tempfile
import shutil
from pathlib import Path
from dotenv import load_dotenv

# --- Imports LangChain ---
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import FAISS
from langchain_classic.chains import RetrievalQA

# --- Configuration ---
# Charge les variables d'environnement (ex: LLMAAS_API_KEY)
load_dotenv()
API_KEY = os.getenv("LLMAAS_API_KEY")
BASE_URL = os.getenv("API_URL", "https://api.ai.cloud-temple.com/v1")
EMBEDDING_MODEL = "granite-embedding:278m"
LLM_MODEL = "gpt-oss:120b"

# --- Pipeline RAG ---
def setup_rag_pipeline(documents_path: str):
    """Configuration complète du pipeline RAG avec les outils LLMaaS."""
    print("1. Chargement et division des documents...")
    loader = DirectoryLoader(documents_path, glob="*.txt", loader_cls=TextLoader, loader_kwargs={'encoding': 'utf-8'})
    documents = loader.load()
    text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
    splits = text_splitter.split_documents(documents)
    print(f"   -> {len(documents)} document(s) chargé(s) et divisé(s) en {len(splits)} chunks.")

    print(f"2. Création des embeddings via LLMaaS (modèle: {EMBEDDING_MODEL})...")
    embeddings = OpenAIEmbeddings(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=EMBEDDING_MODEL,
        check_embedding_ctx_length=False,
        model_kwargs={"encoding_format": "float"},
    )

    print("3. Création de l'index vectoriel en mémoire (FAISS)...")
    vectorstore = FAISS.from_documents(splits, embeddings)
    print("   -> Index FAISS créé avec succès.")

    print(f"4. Configuration du LLM (modèle: {LLM_MODEL})...")
    llm = ChatOpenAI(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=LLM_MODEL,
        temperature=0.3,
        max_tokens=300
    )

    print("5. Création de la chaîne de Question/Réponse (RAG)...")
    qa_chain = RetrievalQA.from_chain_type(
        llm=llm,
        chain_type="stuff",
        retriever=vectorstore.as_retriever(),
        return_source_documents=True
    )
    print("   -> Pipeline RAG prêt.")
    return qa_chain

# --- Exécution ---
def main():
    """Fonction principale pour exécuter le pipeline RAG de bout en bout."""
    if not API_KEY:
        print("Erreur: La variable d'environnement LLMAAS_API_KEY n'est pas définie.")
        return

    # Créer des documents de test temporaires
    temp_dir = tempfile.mkdtemp()
    print(f"\nCréation de documents de test dans: {temp_dir}")
    try:
        documents_content = {
            "overview.txt": "Cloud Temple est un fournisseur de cloud souverain français qualifié SecNumCloud.",
            "pricing.txt": "Consultez le catalogue tarifaire officiel : https://www.cloud-temple.com/nos-tarifs-publics/"
        }
        for filename, content in documents_content.items():
            with open(Path(temp_dir) / filename, 'w', encoding='utf-8') as f:
                f.write(content)

        # Configurer et exécuter le pipeline
        rag_chain = setup_rag_pipeline(temp_dir)

        print("\n--- Interrogation du Pipeline RAG ---")
        question = "Quel est le tarif des tokens en sortie sur l'API LLMaaS de Cloud Temple ?"
        result = rag_chain.invoke({"query": question})

        print(f"\nQuestion: {question}")
        print(f"Réponse: {result['result']}")
        print("\nSources utilisées pour la réponse:")
        for source in result["source_documents"]:
            print(f"- Fichier: {os.path.basename(source.metadata['source'])}")
            print(f"  Contenu: \"{source.page_content}\"")

    finally:
        # Nettoyer le répertoire temporaire
        print(f"\nNettoyage du répertoire temporaire: {temp_dir}")
        shutil.rmtree(temp_dir)

if __name__ == "__main__":
    main()
3. Integration mit einem Vektorspeicher (Qdrant)
Für RAG-Anwendungen in der Produktion wird die Verwendung eines dedizierten Vektorspeichers wie Qdrant empfohlen. Im Gegensatz zu FAISS, das im Speicher arbeitet, bietet Qdrant Datenpersistenz, erweiterte Suchfähigkeiten und eine bessere Skalierbarkeit.
Der Code erklärt
Dieses Tutorial passt die vorherige RAG-Pipeline an, um Qdrant zu verwenden.
- Voraussetzungen: Der erste Schritt besteht darin, eine Qdrant-Instanz zu starten. Der einfachste Weg ist die Verwendung von Docker.
setup_qdrant_rag_pipeline:- Embeddings und Dokumente: Die Erstellung der Embeddings und Dokumente bleibt wie im vorherigen Beispiel.
- Verbindung zu Qdrant: Anstatt einen FAISS-Index zu erstellen, verwenden wir
QdrantVectorStore.from_documents. Diese LangChain-Methode verwaltet mehrere Schritte: a. Sie stellt eine Verbindung zu Ihrer Qdrant-Instanz über die angegebene URL her. b. Sie erstellt eine neue "Collection" (entspricht einer Tabelle in einer SQL-Datenbank), falls sie noch nicht existiert. c. Sie ruft denOpenAIEmbeddings-Client auf, um die Dokumente zu vektorisieren. d. Sie fügt die Dokumente und ihre Vektoren in die Qdrant-Collection ein. force_recreate=True: Für dieses Tutorial verwenden wir diesen Parameter, um sicherzustellen, dass die Collection bei jeder Ausführung leer ist. In der Produktion würden Sie ihn aufFalsesetzen, um Ihre Daten zu behalten.
- Der Rest der Pipeline (LLM-Konfiguration, Erstellung der
RetrievalQA-Kette) ist identisch, was die Flexibilität von LangChain demonstriert: Es reicht aus, die Quelle desretriever(des Informationsbeschaffers) zu ändern, um von FAISS zu Qdrant zu wechseln.
Für dieses Tutorial benötigen Sie eine Qdrant-Instanz. Sie können sie einfach mit Docker starten:
# 1. Télécharger la dernière image de Qdrant
docker pull qdrant/qdrant

# 2. Démarrer le conteneur Qdrant
docker run -p 6333:6333 -p 6334:6334 qdrant/qdrant
Der folgende Code zeigt, wie die RAG-Pipeline angepasst wird, um Qdrant als Vektorspeicher zu verwenden. Die Demo-Dokumente sind kurz; für Ihre eigenen Dokumente wenden Sie eine vorherige Aufteilung wie im FAISS-Tutorial an.
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_classic.chains import RetrievalQA
from langchain_qdrant import QdrantVectorStore
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitter

# --- Configuration ---
load_dotenv()
API_KEY = os.getenv("LLMAAS_API_KEY")
BASE_URL = os.getenv("API_URL", "https://api.ai.cloud-temple.com/v1")
EMBEDDING_MODEL = "granite-embedding:278m"
LLM_MODEL = "gpt-oss:120b"
QDRANT_URL = os.getenv("QDRANT_URL", "http://localhost:6333")
QDRANT_COLLECTION_NAME = "tutorial_collection"

def setup_qdrant_rag_pipeline():
    """Configure et retourne un pipeline RAG utilisant Qdrant."""
    print("1. Initialisation du client d'embedding LLMaaS...")
    embeddings = OpenAIEmbeddings(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=EMBEDDING_MODEL,
        check_embedding_ctx_length=False,
        model_kwargs={"encoding_format": "float"},
    )

    print("2. Préparation des documents...")
    documents_content = [
        "Cloud Temple est un fournisseur de cloud souverain français avec la qualification SecNumCloud.",
        "Les tarifs publics Cloud Temple sont disponibles sur https://www.cloud-temple.com/nos-tarifs-publics/",
    ]
    documents = [Document(page_content=d) for d in documents_content]

    print(f"3. Connexion à Qdrant et peuplement de la collection '{QDRANT_COLLECTION_NAME}'...")
    vectorstore = QdrantVectorStore.from_documents(
        documents,
        embeddings,
        url=QDRANT_URL,
        collection_name=QDRANT_COLLECTION_NAME,
        force_recreate=True, # Assure une collection propre pour le tutoriel
    )
    print("   -> Collection créée et peuplée avec succès.")

    print(f"4. Configuration du LLM ({LLM_MODEL})...")
    llm = ChatOpenAI(
        api_key=API_KEY,
        base_url=BASE_URL,
        model=LLM_MODEL,
        temperature=0.3
    )

    print("5. Création de la chaîne RAG...")
    qa_chain = RetrievalQA.from_chain_type(
        llm=llm,
        retriever=vectorstore.as_retriever(),
        return_source_documents=True
    )
    print("   -> Pipeline RAG avec Qdrant prêt.")
    return qa_chain

# --- Exécution ---
def main_qdrant():
    """Fonction principale pour exécuter le pipeline RAG avec Qdrant."""
    if not API_KEY:
        print("Erreur: La variable d'environnement LLMAAS_API_KEY n'est pas définie.")
        return

    try:
        rag_chain = setup_qdrant_rag_pipeline()
        question = "Quels sont les tarifs de l'API LLMaaS de Cloud Temple ?"

        print(f"\n--- Interrogation du pipeline ---")
        result = rag_chain.invoke({"query": question})

        print(f"\nQuestion: {question}")
        print(f"Réponse: {result['result']}")
        print("\nSources utilisées pour la réponse:")
        for source in result["source_documents"]:
            print(f"- Contenu: \"{source.page_content}\"")

    except Exception as e:
        print(f"\nUne erreur est survenue: {e}")
        print("Veuillez vous assurer que le conteneur Qdrant est bien en cours d'exécution.")

if __name__ == "__main__":
    main_qdrant()
4. LangChain-Agenten mit Tools
Ein Agent ist ein LLM, das nicht nur eine Frage beantwortet, sondern eine Reihe von Tools (Funktionen, APIs usw.) verwenden kann, um eine komplexere Antwort zu erstellen. Es kann schlussfolgern, ein Problem zerlegen, ein Tool auswählen, es ausführen, das Ergebnis beobachten und diesen Zyklus wiederholen, bis eine endgültige Antwort erzielt wird.
Der Code erklärt
Dieses Beispiel erstellt einen einfachen Agenten, der zwei Tools verwenden kann: eines zum Abfragen einer (simulierten) Cloud Temple API und ein anderes für Berechnungen.
- Definition der Tools: Die Klassen
CloudTempleAPIToolundSimpleCalculatorToolerben vonBaseTool. Jedes Tool hat:- Einen
name: einen einfachen und beschreibenden Namen. - Eine
description: entscheidend, das ist es, was das LLM liest, um zu entscheiden, welches Tool verwendet werden soll. Sie muss sehr klar darüber sein, was das Tool tut und wann es verwendet werden soll. - Eine Methode
_run: der Code, der tatsächlich ausgeführt wird, wenn der Agent dieses Tool wählt.
- Einen
create_agent_with_tools:- Initialisierung des LLM: Wir verwenden unseren Wrapper
CloudTempleLLM, der im ersten Tutorial definiert wurde. - Liste der Tools: Wir übergeben dem Agenten die Liste der Tools, die er verwenden darf.
- Prompt des Agenten: Der Prompt ist sehr spezifisch. Es handelt sich um einen "Reasoning-Prompt", der das LLM anweist, wie es denken soll (
Thought), eine Aktion auswählen soll (Action), eine Eingabe für diese Aktion bereitstellen soll (Action Input) und das Ergebnis beobachten soll (Observation). Dies ist der zentrale Mechanismus des hier verwendeten ReAct-Frameworks (Reasoning and Acting). - Erstellung des Agenten:
create_react_agentsetzt das LLM, die Tools und den Prompt zusammen, um den Agenten zu erstellen. AgentExecutor: Dies ist die Engine, die den Agenten in einer Schleife ausführt, bis er eineFinal Answer(Endgültige Antwort) erzeugt. Der Parameterverbose=Trueist sehr nützlich, um den "inneren Monolog" des Agenten (seine Gedanken, Aktionen usw.) zu sehen.
- Initialisierung des LLM: Wir verwenden unseren Wrapper
from langchain_classic.agents import AgentExecutor, create_react_agent
from langchain_core.tools import BaseTool
from langchain_core.prompts import PromptTemplate
import requests
import json
import os

# (La classe CloudTempleLLM est la même que dans le premier exemple)

# --- Définition des Outils ---

class CloudTempleAPITool(BaseTool):
    """Un outil qui simule un appel à une API interne pour obtenir des informations sur les services."""
    name: str = "cloud_temple_api_checker"
    description: str = "Utile pour obtenir des informations sur les services, produits et offres de Cloud Temple."

    def _run(self, query: str) -> str:
        # Dans un cas réel, ceci appellerait une véritable API.
        print(f"--- Outil CloudTempleAPITool appelé avec la requête: '{query}' ---")
        if "service" in query.lower():
            return "Cloud Temple propose les services suivants : IaaS, PaaS, LLMaaS, Sécurité Managée."
        return "Information non trouvée."

    async def _arun(self, query: str) -> str:
        # Implémentation asynchrone non nécessaire pour cet exemple.
        raise NotImplementedError("L'outil API ne supporte pas l'exécution asynchrone.")

class SimpleCalculatorTool(BaseTool):
    """Un outil simple pour effectuer des calculs mathématiques."""
    name: str = "simple_calculator"
    description: str = (
        "Effectue une opération entre deux nombres, séparés par des espaces : "
        "par exemple '125 * 8'. Opérateurs autorisés : +, -, *, /. "
        "Pour un calcul composé, appeler l'outil plusieurs fois."
    )

    def _run(self, expression: str) -> str:
        import math
        import operator

        operations = {
            "+": operator.add,
            "-": operator.sub,
            "*": operator.mul,
            "/": operator.truediv,
        }
        try:
            if len(expression) > 100:
                raise ValueError("Entrée trop longue.")
            left, symbol, right = expression.split()
            if symbol not in operations:
                raise ValueError("Opérateur autorisé : +, -, * ou /.")
            left, right = float(left), float(right)
            if not (math.isfinite(left) and math.isfinite(right)):
                raise ValueError("Les nombres doivent être finis.")
            result = operations[symbol](left, right)
            if not math.isfinite(result):
                raise ValueError("Résultat hors limites.")
            return str(result)
        except (ValueError, OverflowError, ZeroDivisionError) as e:
            return f"Erreur de calcul: {e}"

    async def _arun(self, expression: str) -> str:
        raise NotImplementedError("L'outil Calculatrice ne supporte pas l'exécution asynchrone.")

# --- Création de l'Agent ---

def create_agent():
    """Configure et retourne un agent LangChain avec les outils définis."""
    print("1. Initialisation du LLM pour l'agent...")
    llm = CloudTempleLLM(api_key=os.getenv("LLMAAS_API_KEY", "votre-clé-api-ici"))

    tools = [CloudTempleAPITool(), SimpleCalculatorTool()]

    # Le template de prompt est crucial : il guide le LLM dans son raisonnement.
    template = """
    Réponds aux questions suivantes du mieux que tu peux. Tu as accès aux outils suivants :

    {tools}

    Utilise le format suivant :

    Question: la question à laquelle tu dois répondre
    Thought: tu dois toujours réfléchir à ce que tu vas faire
    Action: l'action à prendre, doit être l'un de [{tool_names}]
    Action Input: l'entrée de l'action
    Observation: le résultat de l'action
    ... (cette séquence Thought/Action/Action Input/Observation peut se répéter)
    Thought: Je connais maintenant la réponse finale.
    Final Answer: la réponse finale à la question d'origine

    Commence !

    Question: {input}
    Thought:{agent_scratchpad}
    """

    prompt = PromptTemplate.from_template(template)

    print("2. Création de l'agent avec le framework ReAct...")
    agent = create_react_agent(llm, tools, prompt)

    # L'AgentExecutor est responsable de l'exécution des cycles de l'agent.
    agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True)
    print("   -> Agent prêt.")
    return agent_executor

# --- Exécution ---

def run_agent():
    """Exécute l'agent avec différentes questions pour tester ses capacités."""
    if os.getenv("LLMAAS_API_KEY") is None:
        print("Veuillez configurer votre LLMAAS_API_KEY.")
        return

    agent_executor = create_agent()

    print("\n--- Test 1 : Question nécessitant un outil d'information ---")
    question1 = "Quels sont les services offerts par Cloud Temple ?"
    response1 = agent_executor.invoke({"input": question1})
    print(f"\nRéponse finale de l'agent: {response1['output']}")

    print("\n--- Test 2 : Question nécessitant un calcul ---")
    question2 = "Quel est le résultat de 125 * 8 + 50 ?"
    response2 = agent_executor.invoke({"input": question2})
    print(f"\nRéponse finale de l'agent: {response2['output']}")

if __name__ == "__main__":
    run_agent()
5. OpenAI SDK Integration
Konfiguration des OpenAI SDK für LLMaaS
Dieses Beispiel verwendet die von LLMaaS unterstützten Aufrufe. Um eine bestehende Anwendung anzupassen, siehe die dokumentierten Unterschiede.
from openai import OpenAI

# Configuration pour Cloud Temple LLMaaS
def setup_cloud_temple_client():
    """Configuration client OpenAI pour Cloud Temple"""

    client = OpenAI(
        api_key="your-cloud-temple-api-key",
        base_url="https://api.ai.cloud-temple.com/v1"
    )

    return client

def test_openai_compatibility():
    """Test de compatibilité avec SDK OpenAI"""

    client = setup_cloud_temple_client()

    # Chat completion standard
    response = client.chat.completions.create(
        model="gpt-oss:120b",
        messages=[
            {"role": "system", "content": "Tu es un assistant IA professionnel."},
            {"role": "user", "content": "Explique-moi l'architecture cloud native."}
        ],
        max_tokens=300,
        temperature=0.7
    )

    print(f"Réponse: {response.choices[0].message.content}")

    # Streaming
    stream = client.chat.completions.create(
        model="gpt-oss:120b",
        messages=[
            {"role": "user", "content": "Écris un poème sur l'IA."}
        ],
        stream=True,
        max_tokens=200
    )

    print("Stream:")
    for chunk in stream:
        if chunk.choices[0].delta.content is not None:
            print(chunk.choices[0].delta.content, end="")
    print()

# Test de compatibilité
test_openai_compatibility()
5. Semantic Kernel Integration (Microsoft)
Semantic Kernel ist ein Open-Source-SDK von Microsoft, das die Integration von LLMs in .NET-, Python- und Java-Anwendungen ermöglicht. Obwohl es für Azure OpenAI-Dienste optimiert ist, ermöglicht seine Flexibilität die Verwendung mit jeder OpenAI-kompatiblen API, einschließlich unserer.
Der Code erklärt
Dieses Beispiel erfordert nicht das vollständige Semantic Kernel SDK. Es demonstriert, wie das Konzept der "semantischen Funktion" durch einen einfachen Aufruf unserer API implementiert werden kann. Eine semantische Funktion ist im Wesentlichen ein strukturierter Prompt, der an ein LLM gesendet wird, um eine bestimmte Aufgabe zu erfüllen.
semantic_kernel_simple(): Diese Funktion simuliert eine "Zusammenfassungsfunktion".- Strukturierter Prompt: Wir verwenden eine
system-Nachricht, um dem LLM eine Rolle zu geben ("Du bist ein Zusammenfassungsexperte.") und eineuser-Nachricht, die den zusammenzufassenden Text enthält. Dies ist der Kern des Konzepts der semantischen Funktion. - Direkter API-Aufruf: Ein einfacher
requests.post-Aufruf an unseren Endpunkt/v1/chat/completionsreicht aus, um die Funktion auszuführen.
Dieses Beispiel zeigt, dass es nicht immer notwendig ist, ein schweres Framework zu verwenden. Für einfache und klar definierte Aufgaben ist ein direkter Aufruf der LLMaaS-API oft die effizienteste und leistungsfähigste Lösung.
import requests
import os
from dotenv import load_dotenv

def semantic_kernel_simulation():
    """
    Simule une "fonction sémantique" de résumé en appelant directement l'API LLMaaS.
    """
    load_dotenv()
    api_key = os.getenv("LLMAAS_API_KEY")
    if not api_key:
        print("Veuillez définir la variable d'environnement LLMAAS_API_KEY.")
        return

    headers = {
        "Authorization": f"Bearer {api_key}",
        "Content-Type": "application/json"
    }

    text_to_summarize = """
    L'intelligence artificielle (IA) transforme de nombreux secteurs industriels en automatisant les tâches,
    en optimisant les processus et en permettant des analyses prédictives avancées.
    Cloud Temple, avec son offre LLMaaS souveraine et certifiée SecNumCloud, permet aux entreprises
    d'intégrer ces capacités d'IA tout en garantissant la sécurité et la confidentialité de leurs données.
    """

    # Le prompt combine une instruction (rôle système) et des données (rôle utilisateur)
    payload = {
        "model": "gpt-oss:120b",
        "messages": [
            {"role": "system", "content": "Tu es un assistant expert en synthèse de documents techniques."},
            {"role": "user", "content": f"Résume le texte suivant en une seule phrase concise: {text_to_summarize}"}
        ],
        "max_tokens": 100,
        "temperature": 0.5
    }

    try:
        response = requests.post(
            "https://api.ai.cloud-temple.com/v1/chat/completions",
            headers=headers,
            json=payload,
            timeout=30
        )
        response.raise_for_status()
        result = response.json()
        summary = result['choices'][0]['message']['content']

        print("Texte original:\n", text_to_summarize)
        print("\nRésumé généré:\n", summary)
        return summary

    except requests.exceptions.RequestException as e:
        print(f"Une erreur d'API est survenue: {e}")

if __name__ == "__main__":
    semantic_kernel_simulation()
6. Haystack Framework
Haystack ist ein weiteres leistungsstarkes Open-Source-Framework zum Erstellen von Anwendungen für semantische Suche, RAG und Agenten. Wie bei Semantic Kernel kann unsere API direkt integriert werden.
Der Code im Detail
Dieses Beispiel simuliert ein grundlegendes Haystack-"Pipeline" für die Beantwortung von Fragen in einem bestimmten Kontext (Question Answering).
process_with_context: Diese Funktion repräsentiert das Herzstück einer QA-Pipeline. Sie nimmt einencontext(z. B. einen Absatz aus einem Dokument) und einequestionentgegen.- Kontextuelles Prompt: Das Prompt ist sorgfältig strukturiert, um sowohl den Kontext als auch die Frage einzuschließen. Dies ist eine grundlegende Technik im RAG: Man stellt dem LLM die relevanten Informationen zur Verfügung, damit er eine faktische Antwort formulieren kann.
- API-Aufruf: Auch hier genügt ein einfacher
requests.post-Aufruf an unsere API. Der LLM erhält den Kontext und die Frage, und seine Aufgabe besteht darin, eine Antwort basierend ausschließlich auf den bereitgestellten Informationen zu synthetisieren.
Dieses Beispiel veranschaulicht die Flexibilität der LLMaaS-API, die als Grundbaustein für die Textgenerierung in jedem Framework dienen kann, sogar in solchen, für die es keine offizielle Integration gibt.
import requests
import os
from dotenv import load_dotenv

def haystack_simulation():
    """
    Simule un pipeline de Question-Answering de type Haystack
    en utilisant un appel direct à l'API LLMaaS.
    """
    load_dotenv()
    api_key = os.getenv("LLMAAS_API_KEY")
    if not api_key:
        print("Veuillez définir la variable d'environnement LLMAAS_API_KEY.")
        return

    headers = {
        "Authorization": f"Bearer {api_key}",
        "Content-Type": "application/json"
    }

    # Le contexte est l'information que le LLM est autorisé à utiliser.
    context = """
    Un cloud souverain est une infrastructure de cloud computing qui est entièrement contenue
    dans les frontières d'un pays spécifique et soumise à ses lois.
    Les principaux avantages sont la garantie de la résidence des données, la conformité avec
    les réglementations locales (comme le RGPD en Europe), et une protection accrue contre
    l'accès par des entités étrangères en vertu de lois extraterritoriales comme le CLOUD Act américain.
    """

    question = "Quels sont les avantages d'un cloud souverain ?"

    # Le prompt guide le LLM pour qu'il base sa réponse sur le contexte fourni.
    prompt = f"""
    En te basant uniquement sur le contexte suivant, réponds à la question.

    Contexte:
    ---
    {context}
    ---

    Question: {question}
    """

    payload = {
        "model": "gpt-oss:120b",
        "messages": [{"role": "user", "content": prompt}],
        "max_tokens": 200,
        "temperature": 0.2 # Température basse pour une réponse factuelle
    }

    try:
        response = requests.post(
            "https://api.ai.cloud-temple.com/v1/chat/completions",
            headers=headers,
            json=payload,
            timeout=30
        )
        response.raise_for_status()
        result = response.json()
        answer = result['choices'][0]['message']['content']

        print(f"Question: {question}")
        print("\nRéponse générée:\n", answer)
        return answer

    except requests.exceptions.RequestException as e:
        print(f"Une erreur d'API est survenue: {e}")

if __name__ == "__main__":
    haystack_simulation()
7. LlamaIndex-Integration
LlamaIndex ist ein Framework, das auf den Aufbau von RAG-Anwendungen spezialisiert ist. Es bietet High-Level-Komponenten für die Datenaufnahme, Indexierung und Abfrage. Da unsere API mit der OpenAI-Schnittstelle kompatibel ist, lässt sie sich sehr einfach integrieren.
Der Code im Detail
Dieses Beispiel zeigt, wie LlamaIndex konfiguriert wird, um die LLMaaS-API für die Textgenerierung zu verwenden, während gleichzeitig ein lokales Embedding-Modell für die Vektorisierung eingesetzt wird.
setup_and_run_llamaindex: Diese einzelne Funktion orchestriert den gesamten Prozess.- LLM-Konfiguration: LlamaIndex stellt eine Klasse
OpenAILikebereit, die die Verbindung zu jeder API ermöglicht, die das OpenAI-Format einhält. Es genügt, unsereapi_baseund einenapi_keybereitzustellen. Dies ist die einfachste Methode, um unseren LLM kompatibel zu machen. - Embedding-Konfiguration: Für dieses Beispiel verwenden wir ein lokales Embedding-Modell (
HuggingFaceEmbedding). Dies zeigt die Flexibilität von LlamaIndex, das die Mischung von Komponenten ermöglicht. Settings: DasSettings-Objekt von LlamaIndex ist eine praktische Möglichkeit, die Standardkomponenten (LLM, Embedding-Modell, Chunk-Größe usw.) zu konfigurieren, die von anderen LlamaIndex-Objekten verwendet werden.- Datenaufnahme:
SimpleDirectoryReaderlädt Dokumente aus einem Ordner. - Index-Erstellung:
VectorStoreIndex.from_documentsist die High-Level-Methode von LlamaIndex. Sie verwaltet automatisch das Aufteilen in Chunks, die Vektorisierung der Chunks (unter Verwendung des inSettingskonfiguriertenembed_model) und die Erstellung des Index im Speicher. - Abfrage-Engine:
.as_query_engine()erstellt eine einfache Schnittstelle, um Fragen an unseren Index zu stellen. Wenn Sie.query()aufrufen, vektorisiert die Engine Ihre Frage, findet die relevantesten Dokumente im Index und sendet sie zusammen mit der Frage an den LLM (konfiguriert inSettings), um eine Antwort zu generieren.
- LLM-Konfiguration: LlamaIndex stellt eine Klasse
# Dépendances:
# pip install llama-index llama-index-llms-openai-like llama-index-embeddings-huggingface

import os
from dotenv import load_dotenv
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader, Settings
from llama_index.llms.openai_like import OpenAILike
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from tempfile import TemporaryDirectory

def setup_and_run_llamaindex():
    """
    Configure et exécute un pipeline RAG simple avec LlamaIndex et l'API LLMaaS.
    """
    load_dotenv()
    api_key = os.getenv("LLMAAS_API_KEY")
    if not api_key:
        print("Veuillez définir la variable d'environnement LLMAAS_API_KEY.")
        return

    # 1. Configuration du LLM pour utiliser l'API LLMaaS via l'interface OpenAILike
    print("1. Configuration du LLM pour pointer vers l'API LLMaaS...")
    llm = OpenAILike(
        api_key=api_key,
        api_base="https://api.ai.cloud-temple.com/v1",
        model="gpt-oss:120b",
        is_chat_model=True,
        # Il est parfois nécessaire d'ajouter des paramètres de contexte pour certains modèles
        # context_window=3900,
    )

    # 2. Configuration du modèle d'embedding (local dans cet exemple pour la simplicité)
    print("2. Configuration du modèle d'embedding local...")
    embed_model = HuggingFaceEmbedding(
        model_name="sentence-transformers/all-MiniLM-L6-v2"
    )

    # 3. Application des configurations globales via l'objet Settings de LlamaIndex
    Settings.llm = llm
    Settings.embed_model = embed_model
    print("   -> LLM et modèle d'embedding configurés.")

    # 4. Création d'une base de connaissances simple dans un répertoire temporaire
    print("4. Création et chargement d'une base de connaissances temporaire...")
    with TemporaryDirectory(prefix="llmaas_llamaindex_") as temp_dir:
        knowledge_file = os.path.join(temp_dir, "knowledge.txt")
        with open(knowledge_file, "w", encoding="utf-8") as f:
            f.write("L'offre LLMaaS de Cloud Temple est une solution d'IA générative souveraine, "
                    "entièrement opérée en France et qualifiée SecNumCloud par l'ANSSI.")

        documents = SimpleDirectoryReader(temp_dir).load_data()
        print(f"   -> {len(documents)} document(s) chargé(s).")
    # Les documents sont en mémoire ; le dossier temporaire est supprimé,
    # y compris si l'écriture ou le chargement échoue.

    # 5. Création de l'index vectoriel. LlamaIndex gère le chunking et l'embedding.
    print("5. Création de l'index vectoriel...")
    index = VectorStoreIndex.from_documents(documents)
    print("   -> Index créé.")

    # 6. Création du moteur de requête et interrogation de la base de connaissances
    print("6. Création du moteur de requête et interrogation...")
    query_engine = index.as_query_engine()
    question = "Quelles sont les garanties de souveraineté de l'offre LLMaaS ?"
    response = query_engine.query(question)

    print(f"\nQuestion: {question}")
    print(f"Réponse: {response}")


if __name__ == "__main__":
    setup_and_run_llamaindex()
8. Konfiguration der CLINE-Erweiterung für VSCode
Dieses Tutorial führt Sie durch die Konfiguration der CLINE-Erweiterung in Visual Studio Code, um die Sprachmodelle von Cloud Temple direkt aus Ihrem Editor zu verwenden.
Konfigurationsschritte
-
CLINE-Einstellungen öffnen: Öffnen Sie in VSCode die Einstellungen der CLINE-Erweiterung.
-
Neues Modell erstellen: Fügen Sie eine neue Modellkonfiguration hinzu.
-
Felder ausfüllen: Konfigurieren Sie die Felder wie folgt, basierend auf dem unten stehenden Bild.
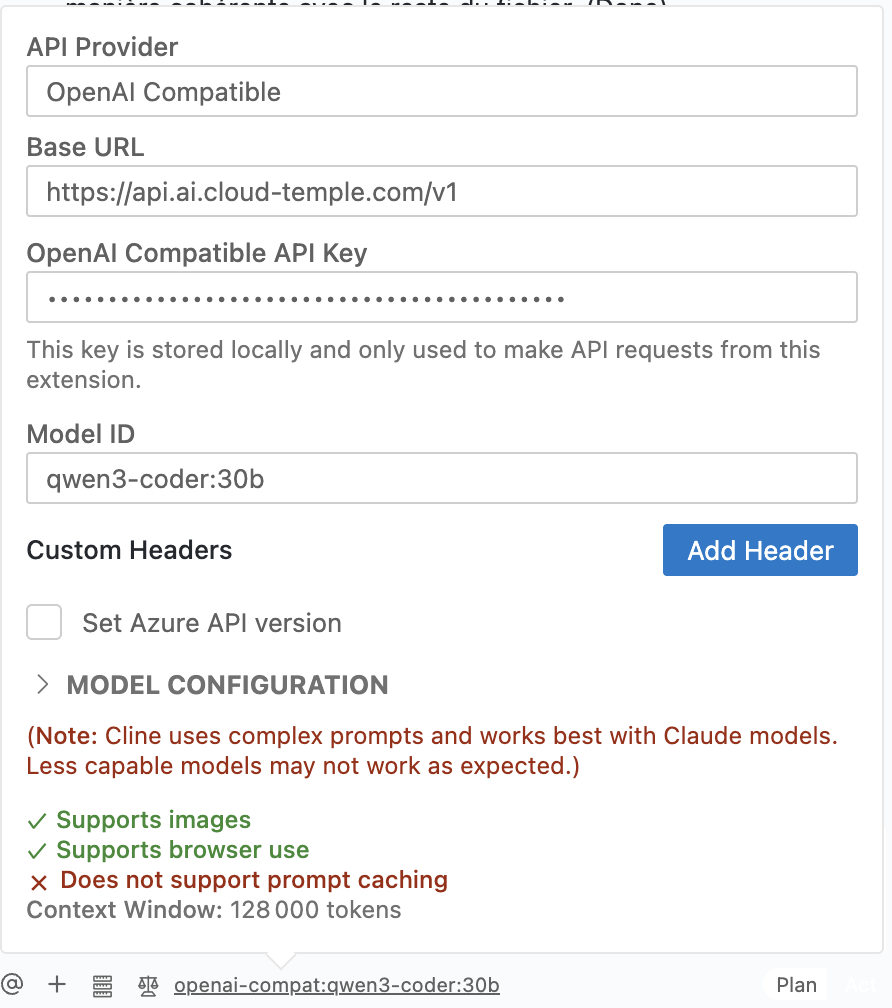
- API Provider: Wählen Sie
OpenAI Compatible. - Base URL: Geben Sie den Endpunkt der Cloud Temple LLMaaS-API ein:
https://api.ai.cloud-temple.com/v1. - OpenAI Compatible API Key: Fügen Sie den API-Schlüssel ein, den Sie in der Cloud Temple-Konsole generiert haben.
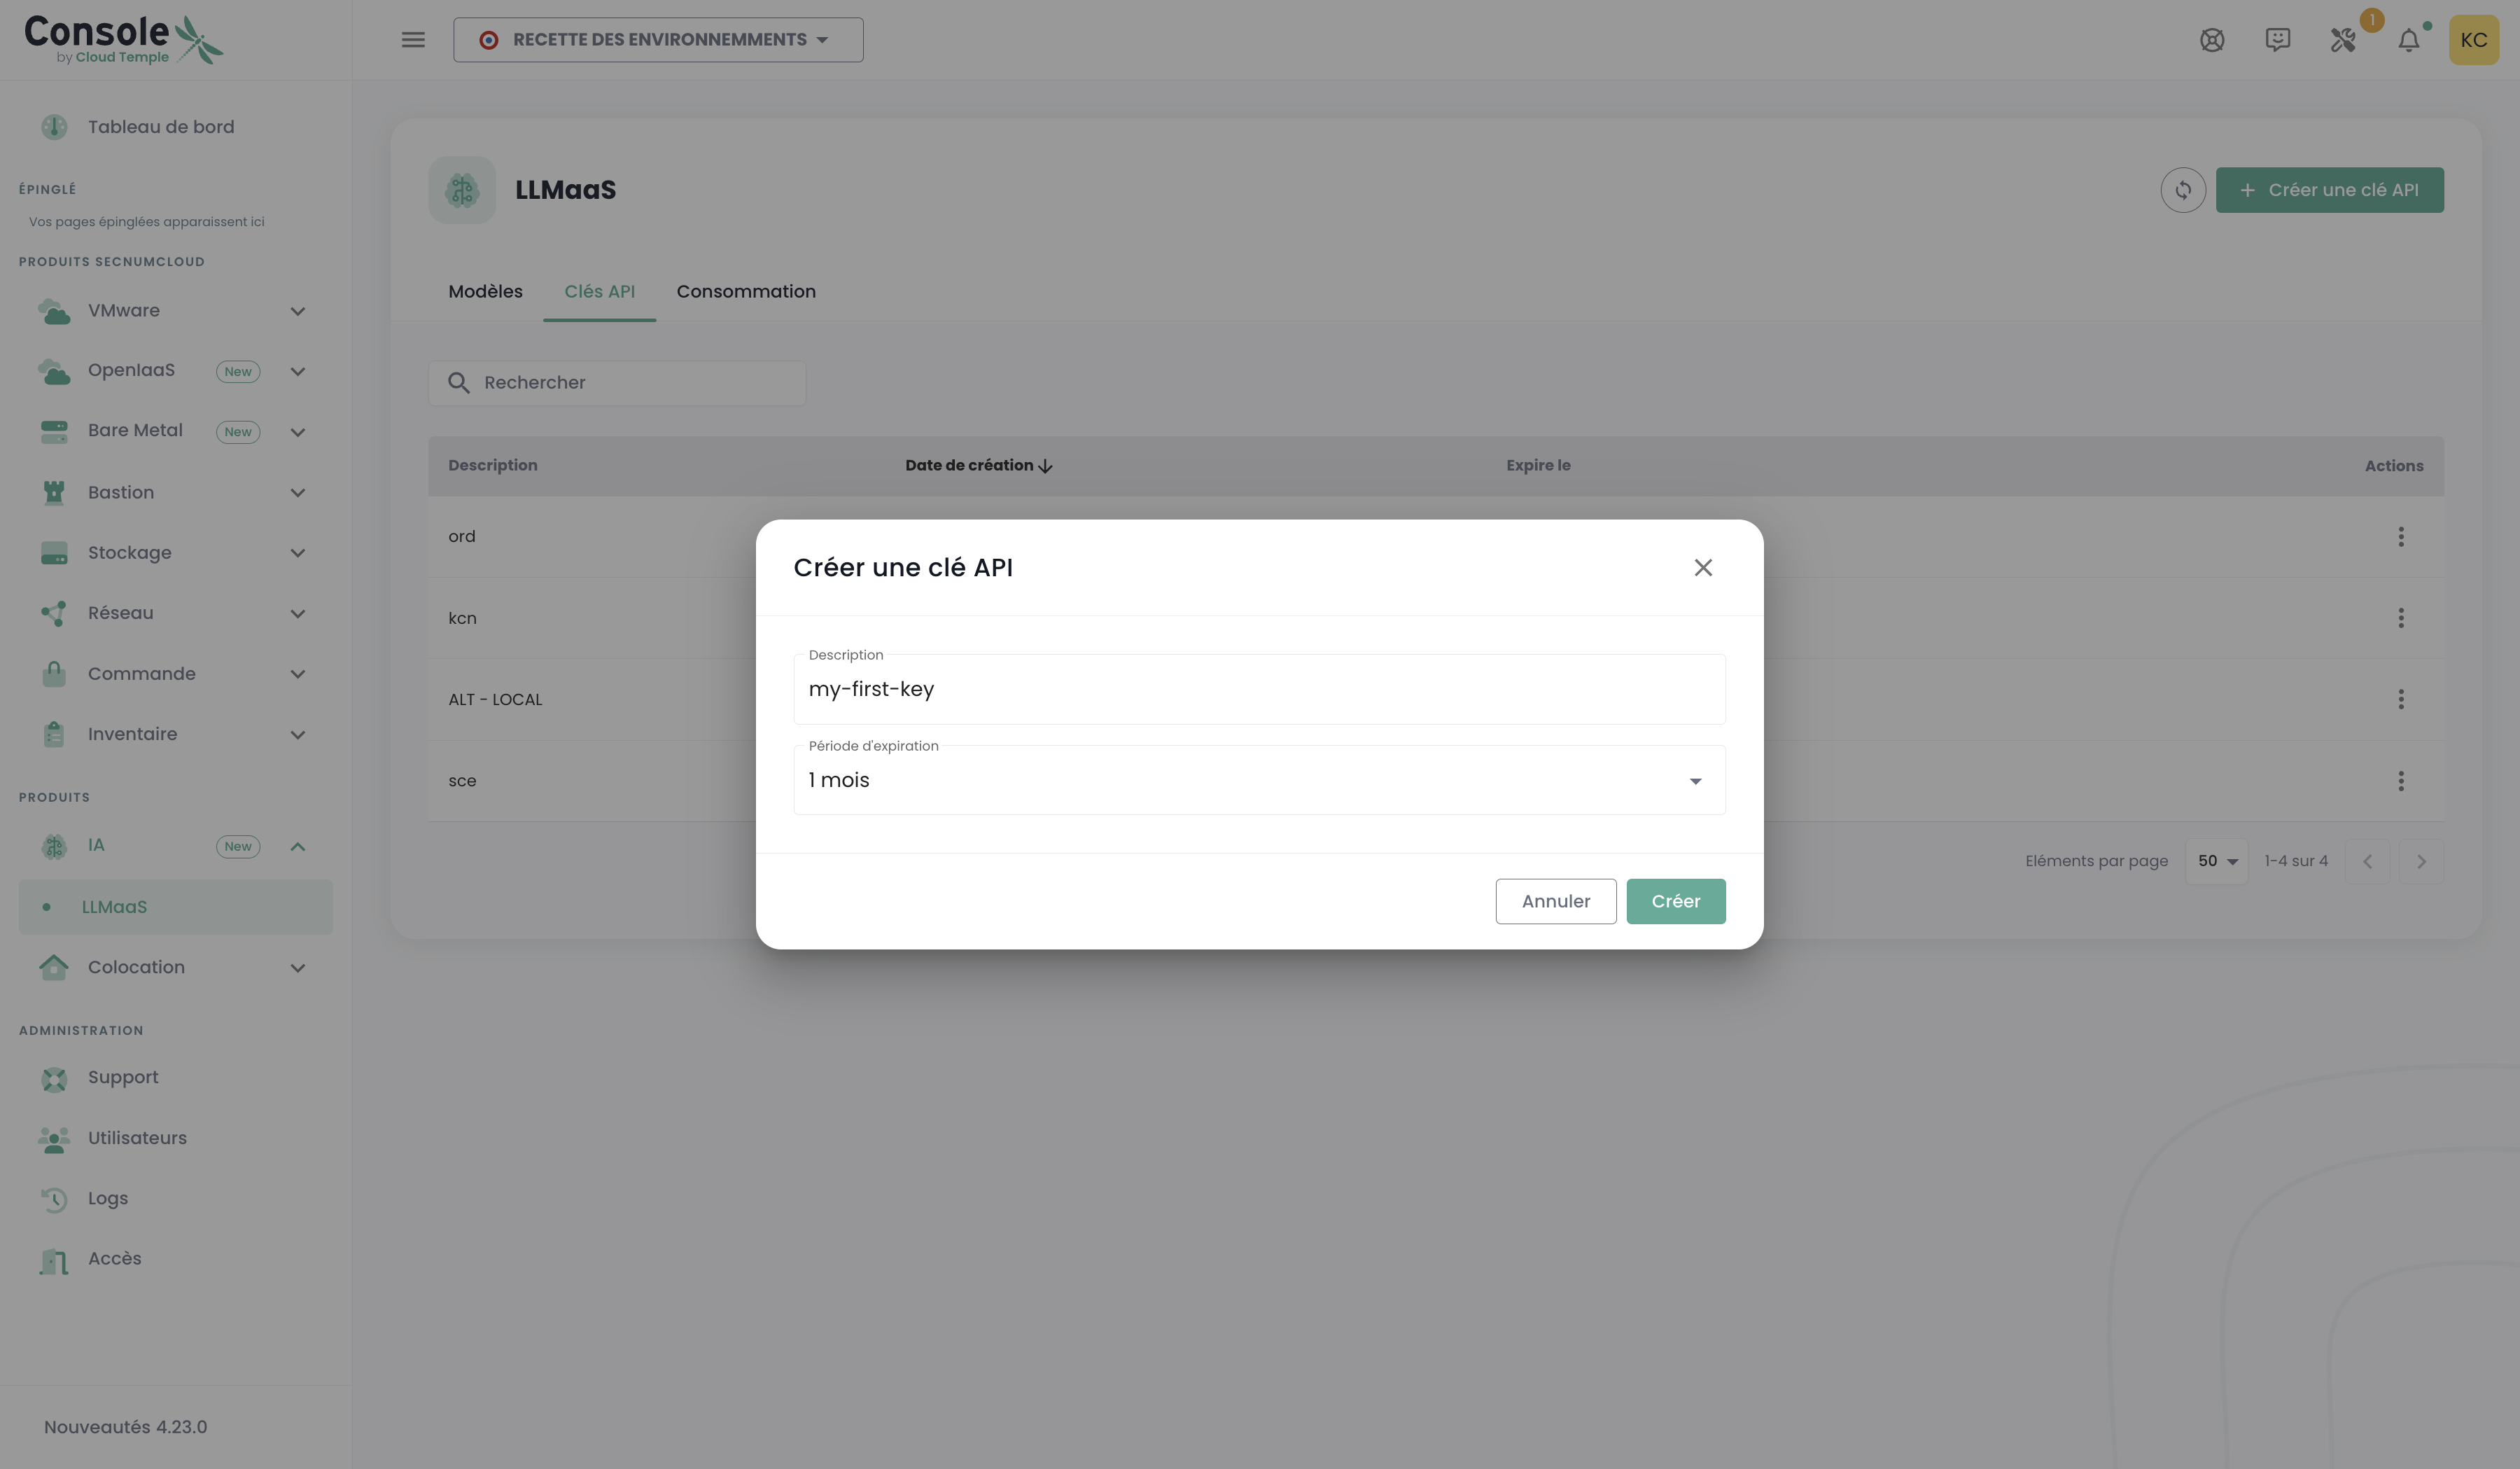
API-Schlüssel generierenUm Ihren API-Schlüssel zu generieren, gehen Sie zur Cloud Temple-Konsole, zum Bereich LLMaaS > API-Schlüssel, und klicken Sie auf "API-Schlüssel erstellen".
- Model ID: Geben Sie das zu verwendende Modell an, z. B.
qwen3.6:35b. Die Liste der verfügbaren Modelle finden Sie im Abschnitt Modelle. - Model Configuration:
- Supports Images: Aktivieren Sie dieses Kästchen, wenn das Modell Bilder unterstützt.
- Supports browser use: Aktivieren Sie dieses Kästchen.
- Context Window Size: Geben Sie die Kontextfenstergröße des Modells an (z. B.
128000). - Max Output Tokens: Lassen Sie den Wert auf
-1, um standardmäßig eine unbegrenzte Ausgabe zu ermöglichen. - Temperature: Stellen Sie die Temperatur nach Ihren Bedürfnissen ein (z. B.
0).
- API Provider: Wählen Sie
Sie können nun ein Modell in CLINE auswählen und es zur Codegenerierung, Beantwortung von Fragen usw. verwenden.
💡 Fortgeschrittene Beispiele
Im untenstehenden GitHub-Verzeichnis finden Sie eine Sammlung von Code-Beispielen und Skripten, die die verschiedenen Funktionen und Anwendungsfälle des LLM as a Service (LLMaaS)-Angebots von Cloud Temple demonstrieren:
Cloud-Temple/product-llmaas-how-to
Dort finden Sie praktische Anleitungen für:
-
Informationsextraktion und Textanalyse: Fähigkeit zur Analyse von Dokumenten zur Extraktion strukturierter Daten wie Entitäten, Ereignisse, Beziehungen und Attribute, basierend auf domänenspezifischen Ontologien (z. B. Recht, Personalwesen, IT).
-
Konversationale Interaktion und Chatbots: Entwicklung von Konversationsagenten, die dialogfähig sind, einen Gesprächsverlauf pflegen, Systemanweisungen (System-Prompts) verwenden und externe Tools aufrufen können.
-
Audio-Transkription (Speech-to-Text): Konvertierung von Audioinhalten in Text, auch für große Dateien, dank Techniken wie Segmentierung, Normalisierung und Batch-Verarbeitung.
-
Textübersetzung: Übersetzung von Dokumenten von einer Sprache in eine andere, wobei der Kontext über mehrere Segmente hinweg berücksichtigt wird, um die Konsistenz zu verbessern.
-
Modellverwaltung und -bewertung: Auflistung der über die API verfügbaren Sprachmodelle, Einsehen ihrer Spezifikationen und Ausführen von Tests zum Vergleich ihrer Leistung.
-
Streaming von Echtzeit-Antworten: Demonstration der Fähigkeit, Antworten der Modelle schrittweise (Token für Token) zu empfangen und anzuzeigen, was für interaktive Anwendungen entscheidend ist.
-
RAG-Pipeline mit speicherbasierter Wissensdatenbank: Pädagogischer RAG-Demonstrator zur Veranschaulichung der Funktionsweise von Retrieval-Augmented Generation. Verwendet die LLMaaS-API für Embedding und Generierung, mit Vektorspeicherung im Speicher (FAISS) für ein klares Verständnis des Prozesses.
-
RAG-Pipeline mit Vektordatenbank (Qdrant): Vollständiger und containerisierter RAG-Demonstrator, der Qdrant als Vektordatenbank verwendet. Die LLMaaS-API wird für das Embedding von Dokumenten und die Generierung augmentierter Antworten eingesetzt.
-
OCR & Dokumentenanalyse (DeepSeek-OCR): Vollständiger Leitfaden und Demonstrationswerkzeug zur Konvertierung von Bildern und PDFs in strukturiertes Markdown, zur Extraktion von Tabellen und zur Transkription mathematischer Formeln. Siehe die dedizierte Dokumentation.