Anleitung: Meistern von OCR mit DeepSeek
Dieser Leitfaden beschreibt die Verwendung des Modells DeepSeek-OCR, eine fortschrittliche Lösung für optische Zeichenerkennung und Dokumentenanalyse.
Dieser Leitfaden beschreibt die Integration von DeepSeek-OCR. Stellen Sie vor der Verwendung sicher, dass das Modell über GET /v1/models verfügbar ist, und konsultieren Sie den Katalog und Lebenszyklus. Falls es nicht verfügbar ist, wählen Sie ein geeignetes Vision-Modell aus und verwenden Sie das entsprechende Anfrageformat; die spezifischen Parameter dieses Leitfadens sind nicht universell gültig.
Architektur und Funktionsweise
Im Gegensatz zu herkömmlichen OCR-Systemen ist DeepSeek-OCR ein End-to-End-Vision-Language-Modell, das darauf ausgelegt ist, Dokumente visuell zu „lesen“ und zu „verstehen“.
Technische Architektur
Es kombiniert zwei innovative Komponenten:
- DeepEncoder (380M): Ein hybrider visueller Encoder, der SAM-base (für lokale Wahrnehmung) und CLIP-large (für globales Wissen) kombiniert, verbunden durch einen 16x konvolutionellen Kompressor. Dies ermöglicht die Verarbeitung hochauflösender Bilder mit sehr wenigen visuellen Tokens.
- MoE-Decoder (3B): Basierend auf DeepSeek3B-MoE (570M aktive Parameter), generiert er strukturierten Text aus den komprimierten visuellen Tokens.
Auflösungsmodi und Ressourcenverbrauch
Das Modell passt seinen Token-Verbrauch an die Bildauflösung an. Je größer das Bild, desto mehr Tokens werden verbraucht, jedoch steigt auch die Genauigkeit.
| Modus | Auflösung (px) | Vision-Tokens | Empfohlene Verwendung |
|---|---|---|---|
| Tiny | 512 x 512 | 64 | Folien, sehr große Schrift |
| Small | 640 x 640 | 100 | Einfache Dokumente, Quittungen |
| Base | 1024 x 1024 | 256 | Standard A4-Seiten |
| Large | 1280 x 1280 | 400 | Dichte Dokumente, kleine Schrift |
| Gundam | Dynamisch | ~800 | Zeitungen, Pläne, komplexe Scans |
Um Kosten und Latenz zu optimieren, skalieren Sie Ihre Bilder auf die minimal erforderliche Auflösung, bei der der Text noch lesbar ist.
Mehrsprachige Unterstützung
Das Modell wurde auf einem umfangreichen Korpus mehrsprachiger Dokumente trainiert und unterstützt die Erkennung von fast 100 Sprachen (einschließlich Französisch, Englisch, Chinesisch, Arabisch usw.), mit oder ohne Beibehaltung des Layouts.
Prompt-Anleitung (Prompt Engineering)
Die Qualität des Ergebnisses hängt direkt vom verwendeten Prompt ab. DeepSeek-OCR reagiert auf spezifische Anweisungen, um seine verschiedenen Fähigkeiten zu aktivieren.
1. Standard-OCR (Markdown)
Zum Extrahieren von Text mit seiner Struktur (Überschriften, Absätze, Tabellen).
Prompt:
Convert the document to markdown.
Ergebnis: Strukturierter Text, formatierte Tabellen, erhaltenes Layout.
2. „Deep Parsing“ (Abbildungen, Diagramme, Formeln)
Zum Analysieren des semantischen Inhalts von Diagrammen, chemischen oder geometrischen Formeln.
Prompt:
Parse the figure.
Fähigkeiten:
- Diagramme (Bar/Line/Pie): Konvertiert in HTML- oder Markdown-Tabellen.
- Chemische Formeln: Konvertiert in SMILES-Format.
- Geometrie: Beschreibt geometrische Elemente.
3. Grounding (Lokalisierung)
Zum Auffinden der Koordinaten eines bestimmten Elements im Bild.
Prompt:
Locate <|ref|>element to find<|/ref|> in the image.
Beispiel: Locate <|ref|>Total<|/ref|> in the image.
Ergebnis: Gibt die Koordinaten der Bounding Box des Elements zurück.
4. Objekterkennung
Zum Auflisten und Lokalisieren aller sichtbaren Objekte.
Prompt:
Identify all objects in the image and output them in bounding boxes.
Implementierungs-Tutorial (Python)
Hier ist ein vollständiges Beispiel, das zeigt, wie Sie Ihren API-Aufruf strukturieren, um diese Fähigkeiten zu nutzen.
Voraussetzungen: Bildformat und Abhängigkeiten
- Format: JPEG oder PNG.
- Modus: RGB (keine Alpha-Transparenz).
- PDF: Müssen vorher in Bilder konvertiert werden (150-300 DPI).
- Größe: Es wird empfohlen, sehr hochauflösende Bilder zu skalieren, um Fehler aufgrund von Größenbeschränkungen (413 Payload Too Large) zu vermeiden.
Installieren Sie die erforderlichen Bibliotheken:
pip install requests Pillow
Code: Dokumentenanalyse (OCR)
Nehmen wir das Beispiel dieser Schweizer Quittung:
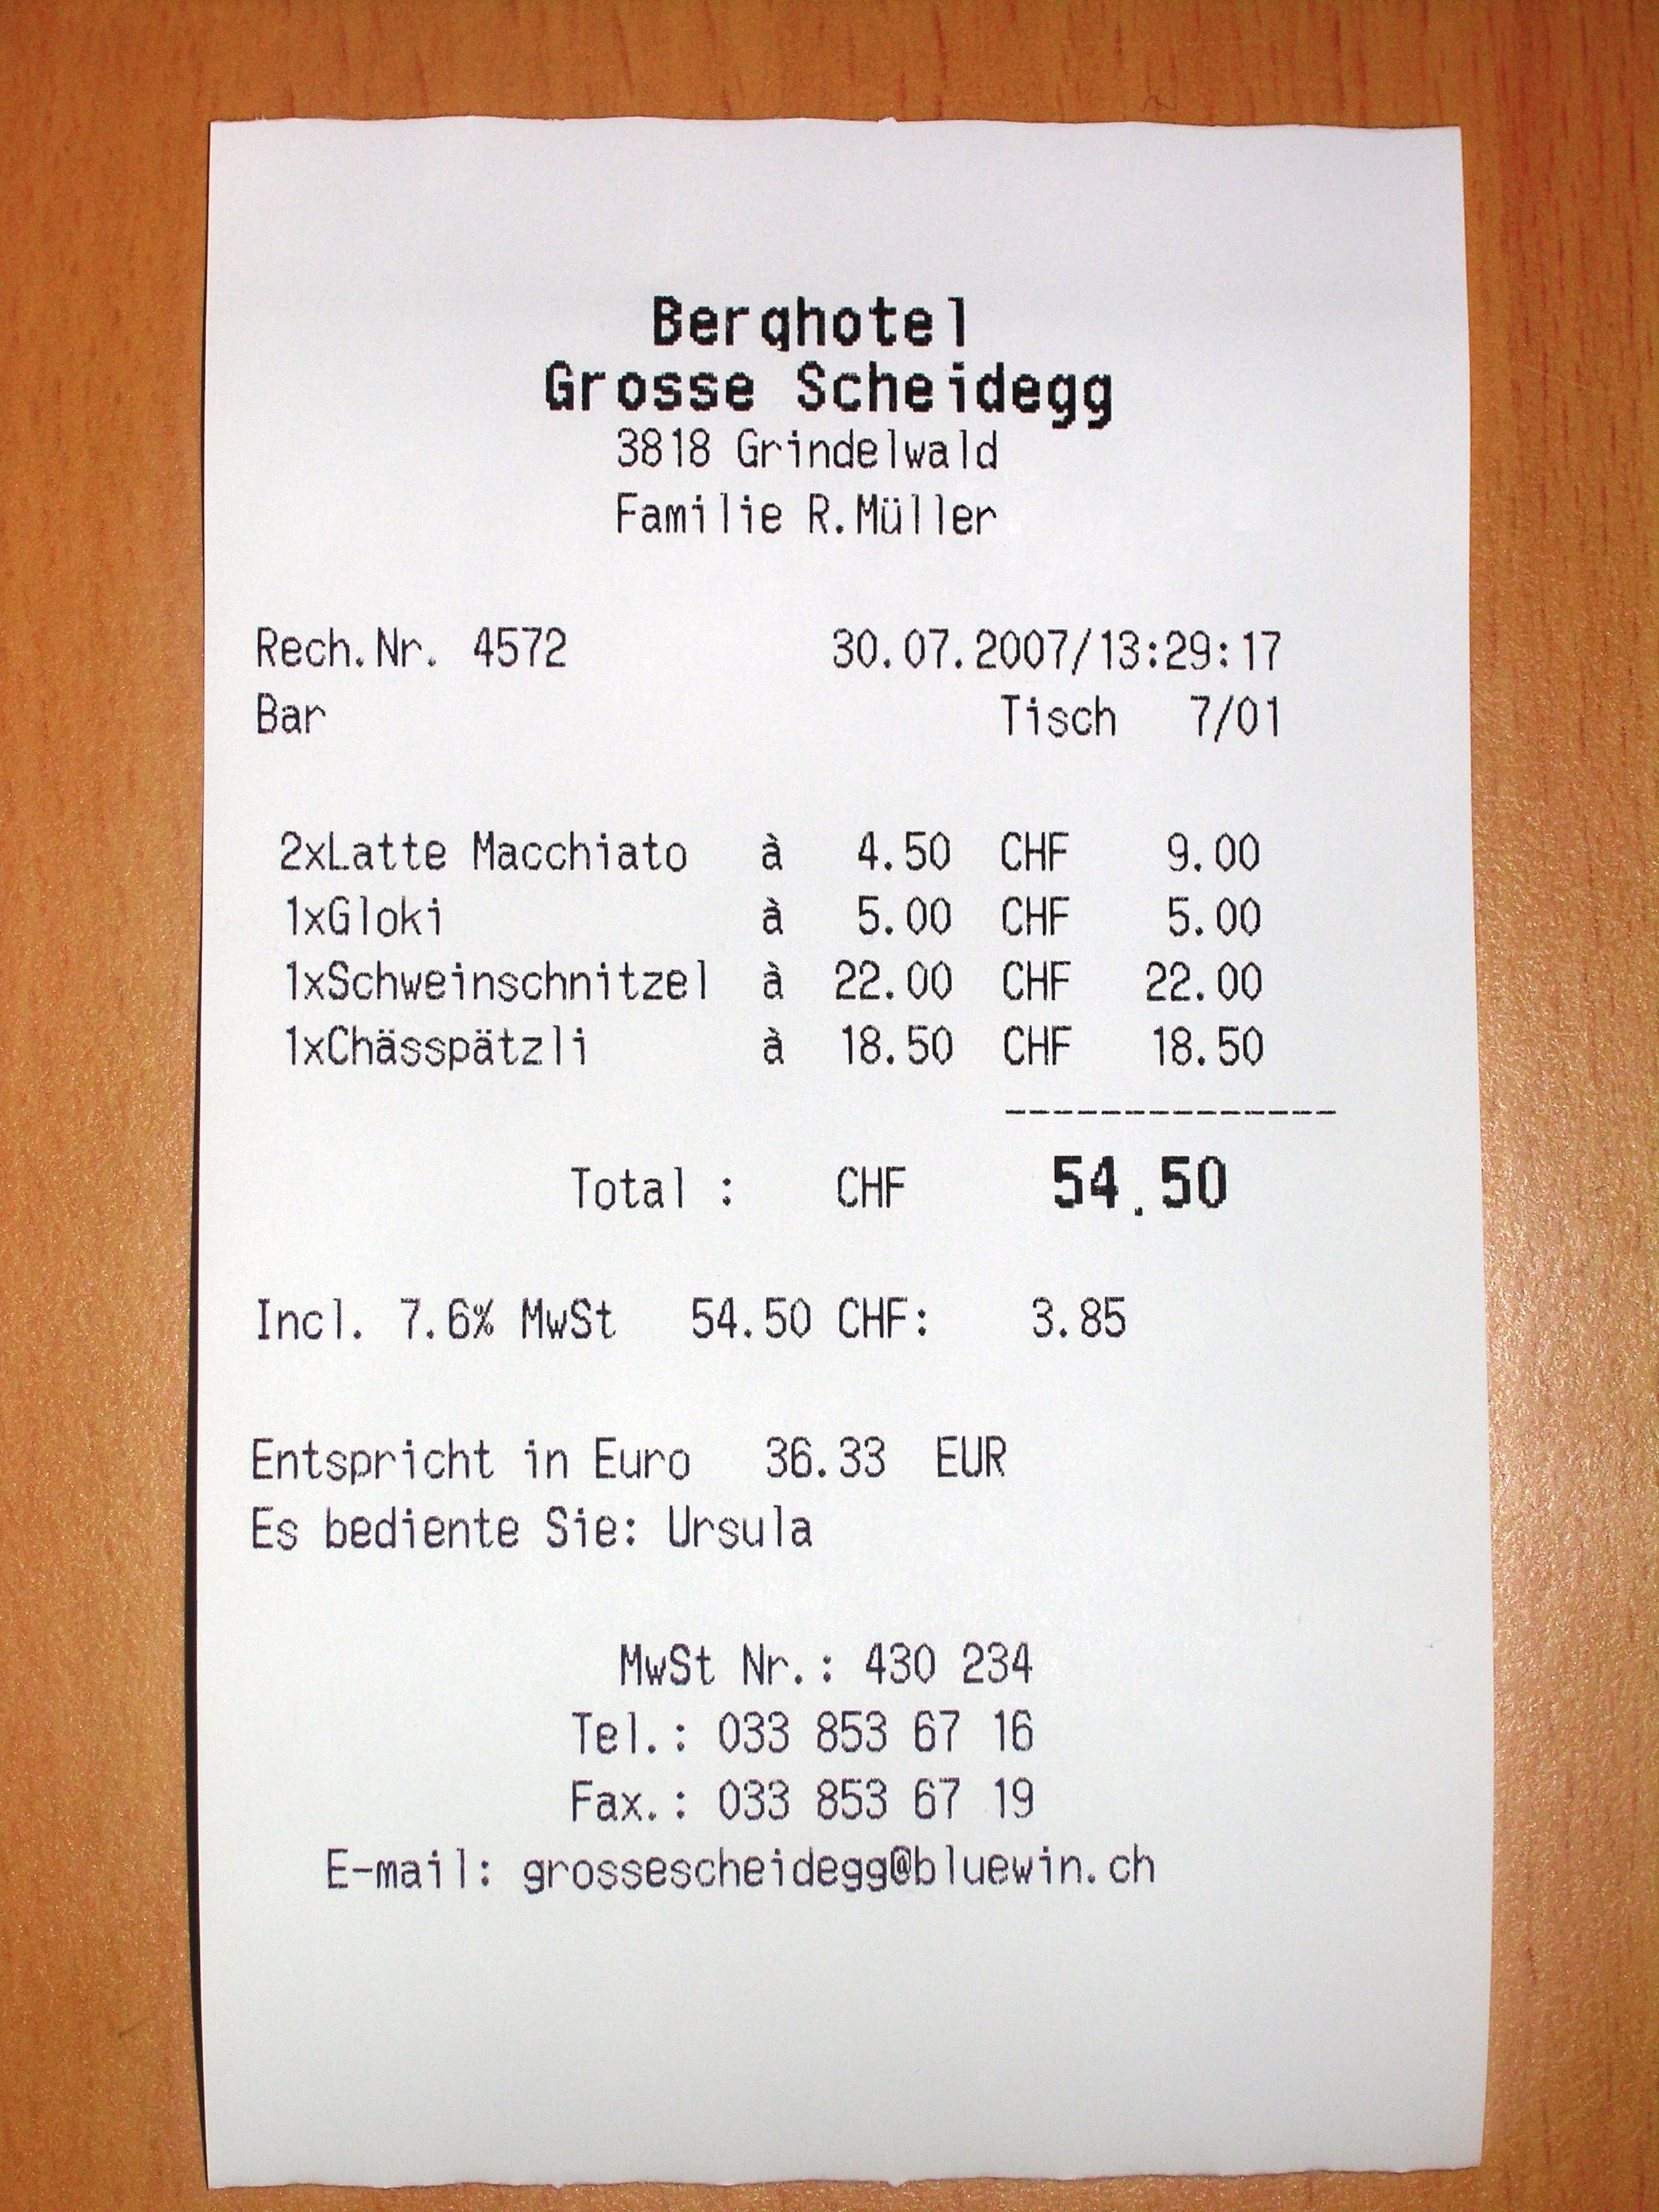
Hier ist ein robustes Skript, das das Skalieren und die optimale Codierung des Bildes handhabt:
import base64
import io
import requests
from PIL import Image

# Configuration
API_KEY = "VOTRE_TOKEN_API"
API_URL = "https://api.ai.cloud-temple.com/v1/chat/completions"
IMAGE_PATH = "ReceiptSwiss.jpg" # Assurez-vous que l'image est dans le dossier courant

def encode_image_optimized(path):
    """
    Optimise l'image (redimensionnement + compression JPEG) pour l'API.
    """
    with Image.open(path) as img:
        # 1. Conversion RGB (pour éviter problèmes PNG/Alpha)
        if img.mode != 'RGB':
            img = img.convert('RGB')

        # 2. Redimensionnement intelligent si trop grand (> 2048px)
        # Cela évite l'erreur 413 (Payload Too Large) et accélère le traitement
        max_size = 2048
        if max(img.size) > max_size:
            img.thumbnail((max_size, max_size))

        # 3. Compression JPEG en mémoire
        buffer = io.BytesIO()
        img.save(buffer, format="JPEG", quality=85)

        return base64.b64encode(buffer.getvalue()).decode('utf-8')

# 1. Construction du message multimodal
encoded_image = encode_image_optimized(IMAGE_PATH)

payload = {
    "model": "deepseek-ai/DeepSeek-OCR",
    "messages": [
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": "Convert the document to markdown." # Prompt OCR Standard
                },
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/jpeg;base64,{encoded_image}"
                    }
                }
            ]
        }
    ],
    "temperature": 0.0, # CRUCIAL : 0.0 pour la fidélité
    "max_tokens": 4096
}

# 2. Envoi
print("Envoi de la requête...")
response = requests.post(
    API_URL,
    headers={"Authorization": f"Bearer {API_KEY}"},
    json=payload
)

# 3. Résultat
if response.status_code == 200:
    print("\n--- Résultat OCR ---\n")
    print(response.json()['choices'][0]['message']['content'])
else:
    print(f"Erreur {response.status_code}: {response.text}")
Beispielausgabe:
# Berghotel
**Grosse Scheidegg**
3818 Grindelwald
Familie R. Müller

Rech. Nr.  4572
Bar    Tisch   7/01

2xLatte Macchiato    à   4.50 CHF   9.00
1xGloki    à   5.00 CHF   5.00
...

**Total :** CHF **54.50**
**Incl. 7.6% MwSt** 54.50 CHF: 3.85
Code: Diagrammanalyse (Deep Parsing)
Um ein Finanzdiagramm in einem Bericht zu analysieren, ändern Sie einfach den Text des Prompts im obigen Payload:
# ... dans le payload ...
"text": "Parse the figure."
# ...
Das Modell gibt eine textuelle oder tabellarische Darstellung der Diagrammdaten zurück.
Erweiterte Anwendungsfälle
Extraktion komplexer Tabellen
DeepSeek-OCR ist hervorragend darin, Tabellen zu konvertieren, selbst wenn keine klaren Trennlinien vorhanden sind.
Eingabebild — fiktives technisches Inventar:

Diese Daten veranschaulichen die Extraktion einer Tabelle; sie definieren keine kommerziellen Vorlagen von Cloud Temple.
Erwartete Markdown-Ausgabe:
| Équipement | Quantité | vCPU | RAM (Gio) |
|---|---|---|---|
| Serveur web | 2 | 4 | 16 |
| Serveur de calcul | 1 | 8 | 32 |
| Serveur de test | 3 | 2 | 8 |
Für öffentliche Preise des Dienstes konsultieren Sie den offiziellen Cloud Temple Preiskatalog.
Mathematische Formeln (LaTeX)
Ideal für akademische Dokumente. Das Modell erkennt Gleichungen und gibt sie in standardmäßiger LaTeX-Syntax aus.
Eingabebild:
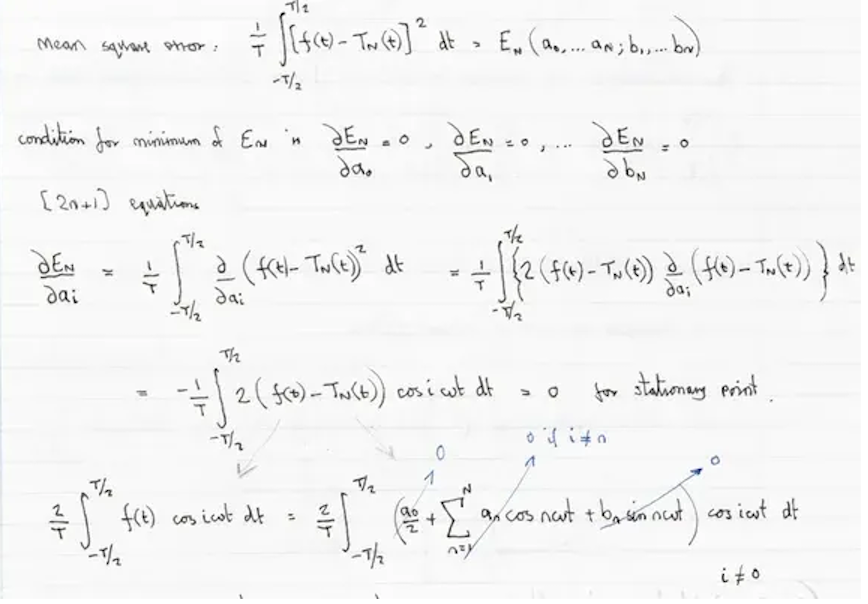
Modellausgabe (Prompt: "Convert to latex.") :
Hier ist das mathematische Rendering des OCR-Ergebnisses:
Mean square error:
Condition for minimum of in:
(2n+1) equations:
Bekannte Einschränkungen
- Ausrichtung: Das Modell unterstützt keine automatische Drehung. Stellen Sie sicher, dass Ihre Bilder korrekt ausgerichtet sind (horizontaler Text).
- Handschrift: Obwohl leistungsfähig, ist die Fehlerrate bei komplexer kursiver Handschrift höher als bei gedrucktem Text.
- Sehr hohe Auflösung: Bilder, die die Abmessungen des „Gundam“-Modus (~2000x2000) überschreiten, werden skaliert, was mikroskopischen Text unleserlich machen kann. Teilen Sie sehr große Pläne in mehrere Bilder auf.