LLMaaS-Konzepte und Architektur
Überblick
Der LLMaaS-Service (Large Language Models as a Service) von Cloud Temple bietet sicheren und souveränen Zugang zu den fortschrittlichsten KI-Modellen mit der SecNumCloud-Zertifizierung der ANSSI.
🏗️ Technische Architektur
Cloud Temple Infrastruktur
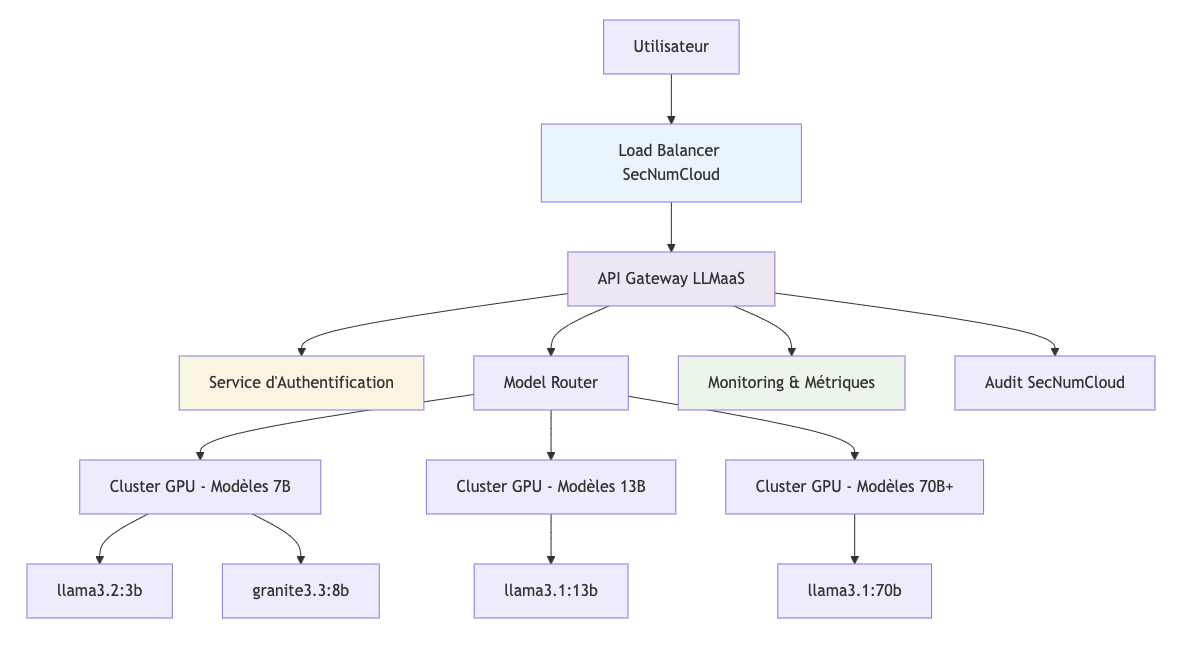
Hauptkomponenten
1. LLMaaS API Gateway
- OpenAI-kompatibel: Nahtlose Integration in bestehende Ökosysteme
- Rate Limiting: Verwaltung von Kontingenten nach Abrechnungsstufe
- Load Balancing: Verteilung der Anfragen auf Inferenz-Ressourcen
- Monitoring: Echtzeitmetriken und Alarmierung
2. Authentifizierungsdienst
- API-Schlüssel: Erstellung, Rotation und Widerruf unter Verantwortung des Kunden. Siehe Verantwortungsteilung (RACI).
- Zugriffskontrolle: Granulare Berechtigungen pro Modell
- Audit-Trails: Vollständige Nachverfolgbarkeit der Zugriffe
🤖 Modelle und Tokens
Modellkatalog
Siehe Katalog und Lebenszyklus sowie Auswahlführer.
Token-Verwaltung
Token-Arten
- Eingabetokens: Ihr Prompt und Kontext
- Ausgabetokens: Vom Modell generierte Antwort
- Systemtokens: Metadaten und Anweisungen
Kostenberechnung
Um die aktuellen öffentlichen Preise zu erfahren und Ihre Schätzung zu erstellen, konsultieren Sie den offiziellen Cloud Temple Preis-Katalog.
Die Kosten hängen von den verbrauchten Volumina (Tokens, Dokumente oder Audiodauer) und den geltenden Abrechnungseinheiten ab.
Optimierung
- Context Window: Wiederverwendung von Konversationen zur Einsparung
- Passende Modelle: Wählen Sie die Größe entsprechend der Komplexität
- Max Tokens: Begrenzung der Antwortlänge
Tokenisierung
# Exemple d'estimation de tokens
def estimate_tokens(text: str) -> int:
    """Estimation approximative : 1 token ≈ 4 caractères"""
    return len(text) // 4

prompt = "Expliquez la photosynthèse"
response_max = 200  # tokens max souhaités

estimated_input = estimate_tokens(prompt)  # ~6 tokens
print(f"Tokens estimés : {estimated_input}; limite de sortie : {response_max}")
🔒 Sicherheit und Compliance
SecNumCloud-Zertifizierung
Der LLMaaS-Dienst läuft auf einer technischen Infrastruktur, die die SecNumCloud 3.2-Zertifizierung der ANSSI genießt, was garantiert:
Datenschutz
- End-to-End-Verschlüsselung: TLS 1.3 für alle Übertragungen
- Sichere Speicherung: Daten in Ruhe verschlüsselt (AES-256)
Digitale Souveränität
- Hosting in Frankreich: Zertifizierte Cloud Temple Rechenzentren
- Französisches Recht: Native DSGVO-Konformität
- Keine Exposition: Keine Übertragung in ausländische Clouds
Audit und Nachverfolgbarkeit
- Vollständige Logs: Alle Interaktionen werden protokolliert
- Aufbewahrung: Speicherung gemäß gesetzlichen Richtlinien
- Compliance: Audit-Berichte verfügbar
Sicherheitskontrollen

Prompt-Sicherheit
Die LLMaaS-Plattform wendet keine automatische Inhaltsfilterung von Prompts gegen Injektionen oder Versuche zur Umgehung von Anweisungen (Jailbreaks) an.
Inhaltskontrollen müssen in Ihrer Anwendung entsprechend Ihrem Anwendungsfall implementiert werden. Sie können explizit ein Sicherheitsmodell aus dem Katalog aufrufen, um Eingaben oder Antworten zu bewerten. Diese Modelle werden nicht automatisch für Anfragen an andere Modelle ausgeführt.
Legen Sie die Filterkriterien und die Verarbeitung der Ergebnisse mit Ihren Fachabteilungen fest und testen Sie diese an Ihren Daten, insbesondere zur Messung von falsch-positiven Ergebnissen. Die Verantwortungsteilung definiert die Rollen des Kunden und von Cloud Temple.
📈 Leistung und Skalierbarkeit
Echtzeit-Monitoring
Zugriff über die Cloud Temple Konsole:
- Nutzungsmetriken pro Modell
- Latenz- und Durchsatzdiagramme
- Alarme bei Leistungsschwellenwerten
- Anfragehistorie
🌐 Integration und Ökosystem
OpenAI-Kompatibilität
Der LLMaaS-Dienst ist kompatibel mit der OpenAI-API:
# Migration transparente
from openai import OpenAI

# Avant (OpenAI)
client_openai = OpenAI(api_key="sk-...")

# Après (Cloud Temple LLMaaS)
client_ct = OpenAI(
    api_key="votre-token-cloud-temple",
    base_url="https://api.ai.cloud-temple.com/v1"
)

# Code identique !
response = client_ct.chat.completions.create(
    model="gpt-oss:120b",  # Modèle Cloud Temple
    messages=[{"role": "user", "content": "Bonjour"}]
)
Unterstütztes Ökosystem
KI-Frameworks
- ✅ LangChain: Native Integration
- ✅ Haystack: Dokumenten-Pipelines
- ✅ Semantic Kernel: Microsoft-Orchestrierung
- ✅ AutoGen: Konversationsagenten
Entwicklungstools
- ✅ Jupyter: Interaktive Notebooks
- ✅ Streamlit: Schnelle Webanwendungen
- ✅ Gradio: KI-Benutzeroberflächen
- ✅ FastAPI: Backend-APIs
No-Code-Plattformen
- ✅ Zapier: Automatisierungen
- ✅ Make: Visuelle Integrationen
- ✅ Bubble: Webanwendungen
🔄 Modell-Lebenszyklus
Der Modell-Lebenszyklus veröffentlicht Status, Fristen und empfohlene Migrationen. Konsultieren Sie ihn vor der Modellauswahl und während des Betriebs Ihrer Anwendung.
Lebenszyklus lesen
- DMP (Date de Mise en Production): Produktionsfreigabedatum.
- DSP (Date de Sortie de Production): Für das Modell angekündigtes Produktionsausgangsdatum (Ende des Supports).
- LTS (Long Term Support): Modell mit erweitertem Support; prüfen Sie das veröffentlichte Datum für das betreffende Modell.
- Production: Im Katalog als in Produktion befindliches Modell gekennzeichnet.
- Deprecated: Veraltetes Modell, für das eine Migration vorbereitet werden muss. Dieser Status bedeutet nicht unbedingt, dass API-Aufrufe bereits unterbrochen wurden.
- Planned: Angekündigtes Modell, dessen Verfügbarkeit vor der Nutzung überprüft werden muss.
Ankündigungen zu Hinzufügungen, Umleitungen und Rückzügen werden im Service-Changelog veröffentlicht. Bei Bedarf an besonderer Stabilität oder Support kontaktieren Sie den Support, um die geltenden Modalitäten zu präzisieren.
Umleitungen und alte Bezeichner
Einige alte Bezeichner werden auf ein Nachfolgermodell umgeleitet. Eine Anfrage kann daher weiterhin funktionieren, wird aber von einem anderen Modell verarbeitet. Die Kontinuität des API-Aufrufs garantiert keine identischen Antworten, noch dieselben Fähigkeiten, Latenzen oder Kontextgrenzen.
Migration zu einem anderen Modell
- Identifizieren Sie das betroffene Modell, die Frist und das empfohlene Nachfolgermodell im Lebenszyklus.
- Überprüfen Sie den Bezeichner des Nachfolgers mit
GET /v1/modelsund dessen Fähigkeiten: Vision, Tool-Aufrufe, Reasoning und Kontext entsprechend Ihrer Nutzung. - Testen Sie den Nachfolger an einer repräsentativen Stichprobe Ihrer Anfragen: Qualität, Ausgabeformate, Tools, Latenz und Verbrauch.
- Aktualisieren Sie den
model-Parameter in der Konfiguration Ihrer Anwendung nach Validierung und überwachen Sie die Ergebnisse. - Für Embeddings planen Sie das Neuberechnen der Vektoren und den Wiederaufbau des Index, falls sich das Modell ändert.
Veraltete Modelle
Die Liste und die Migrationsziele sind im Lebenszyklus-Katalog verfügbar. Wenn keine Migration angegeben ist, kontaktieren Sie den Support vor Ablauf der Frist, um eine passende Lösung zu wählen.
💡 Best Practices
Um das Beste aus der LLMaaS-API herauszuholen, ist es entscheidend, Strategien zur Optimierung von Kosten, Leistung und Sicherheit zu übernehmen.
Kostenoptimierung
Die Kostenkontrolle basiert auf einer intelligenten Nutzung von Tokens und Modellen.
-
Modellauswahl: Vergleichen Sie mehrere Modelle an repräsentativen Beispielen Ihrer Nutzung. Wählen Sie dasjenige, das Ihre Qualitäts- und Latenzanforderungen erfüllt, und messen Sie dann seinen Token-Verbrauch. Konsultieren Sie den Lebenszyklus-Katalog, um verfügbare Modelle und ihre Nachfolger zu identifizieren. Die Abrechnung hängt vom geltenden Tarif und den verbrauchten Volumina ab; allein die Modellgröße bestimmt nicht die berechneten Kosten.
-
Kontextverwaltung: Der Konversationsverlauf (
messages) wird bei jedem Aufruf zurückgesendet und verbraucht Eingabetokens. Bei langen Konversationen erwägen Sie Zusammenfassungs- oder Fensterungsstrategien, um nur relevante Informationen zu behalten.# Bei einer langen Konversation können die ersten Austausche zusammengefasst werden.messages = [{"role": "system", "content": "Sie sind ein KI-Assistent."},{"role": "user", "content": "Zusammenfassung der ersten 10 Austausche..."},{"role": "assistant", "content": "Ok, ich habe den Kontext."},{"role": "user", "content": "Hier ist meine neue Frage."}] -
Begrenzung der Ausgabetokens: Verwenden Sie immer den Parameter
max_tokens, um übermäßig lange und kostspielige Antworten zu vermeiden. Legen Sie ein angemessenes Limit fest, basierend auf Ihren Erwartungen.# Eine Zusammenfassung von maximal 100 Wörtern anfordern.response = client.chat.completions.create(model="gpt-oss:120b",messages=[{"role": "user", "content": "Fassen Sie dieses Dokument zusammen..."}],max_tokens=150, # Sicherheitsmarge für ~100 Wörter)
Leistung
Die Reaktionsfähigkeit Ihrer Anwendung hängt davon ab, wie Sie API-Aufrufe verwalten.
-
Asynchrone Anfragen: Um mehrere Anfragen zu verarbeiten, ohne auf das Ende jeder einzelnen zu warten, verwenden Sie asynchrone Aufrufe. Dies ist besonders nützlich für Backend-Anwendungen, die ein hohes Volumen gleichzeitiger Anfragen verarbeiten.
import asynciofrom openai import AsyncOpenAIclient = AsyncOpenAI(api_key="...", base_url="...")async def process_prompt(prompt: str):# Verarbeitet eine einzelne Anfrage asynchronresponse = await client.chat.completions.create(model="gpt-oss:120b", messages=[{"role": "user", "content": prompt}])return response.choices[0].message.contentasync def batch_requests(prompts: list):# Startet mehrere Aufgaben parallel und wartet auf deren Abschlusstasks = [process_prompt(p) for p in prompts]return await asyncio.gather(*tasks) -
Streaming für die Benutzererfahrung (UX): Für Benutzeroberflächen (Chatbots, Assistenten) ist Streaming unerlässlich. Es ermöglicht die Anzeige der Modellantwort Wort für Wort, was einen Eindruck sofortiger Reaktionsfähigkeit vermittelt, anstatt auf die vollständige Antwort zu warten.
# Zeigt die Antwort in Echtzeit in einer Benutzeroberfläche anresponse_stream = client.chat.completions.create(model="gpt-oss:120b",messages=[{"role": "user", "content": "Erzählen Sie mir eine Geschichte."}],stream=True)for chunk in response_stream:if chunk.choices[0].delta.content:# Zeigt den Textabschnitt in der UI anprint(chunk.choices[0].delta.content, end="", flush=True)
Sicherheit
Die Sicherheit Ihrer Anwendung ist von größter Bedeutung, insbesondere wenn Sie Benutzereingaben verarbeiten.
-
Validierung und Bereinigung der Eingaben (Sanitization): Vertrauen Sie Benutzereingaben niemals. Bereinigen Sie diese vor dem Senden an die API, um potenziell schädlichen Code oder Anweisungen zur „Prompt-Injektion“ zu entfernen. Beschränken Sie auch deren Größe, um Missbrauch zu verhindern.
def sanitize_input(user_input: str) -> str:# Einfaches Beispiel: Entfernen von Code-Markierungen und Begrenzen der Länge.# Für eine erweiterte Sanitization können robustere Bibliotheken verwendet werden.cleaned = user_input.replace("`", "").replace("'", "").replace("\"", "")return cleaned[:2000] # Begrenzt die Größe auf 2000 Zeichen -
Robuste Fehlerbehandlung: Umgeben Sie Ihre API-Aufrufe immer mit
try...except-Blöcken, um Netzwerkfehler, API-Fehler (z. B. 429 Rate Limit, 500 Internal Server Error) zu behandeln und eine eingeschränkte, aber funktionale Benutzererfahrung bereitzustellen.from openai import APIError, APITimeoutErrortry:response = client.chat.completions.create(...)except APITimeoutError:# Behandeln Sie den Fall, dass die Anfrage zu lange dauertreturn "Der Dienst benötigt mehr Zeit als erwartet, bitte versuchen Sie es erneut."except APIError as e:# Behandeln Sie spezifische API-Fehlerlogger.error(f"LLMaaS-API-Fehler: {e.status_code} - {e.message}")return "Entschuldigung, ein Fehler ist mit dem KI-Dienst aufgetreten."except Exception as e:# Behandeln Sie alle anderen Fehler (Netzwerk usw.)logger.error(f"Ein unerwarteter Fehler ist aufgetreten: {e}")return "Entschuldigung, ein unerwarteter Fehler ist aufgetreten."